“지난달 매출이 왜 줄었는지 봐 줘.” 이 질문을 받으면 먼저 주문 테이블을 찾고, 취소와 환불의 정의를 확인하고, 쿼리를 실행한 다음 결과가 맞는지 원장과 대조하게 됩니다. AI가 SQL 문장을 작성해 주더라도 스키마와 오류 메시지를 사람이 계속 복사해 전달한다면 작업의 절반은 여전히 사람 몫입니다.
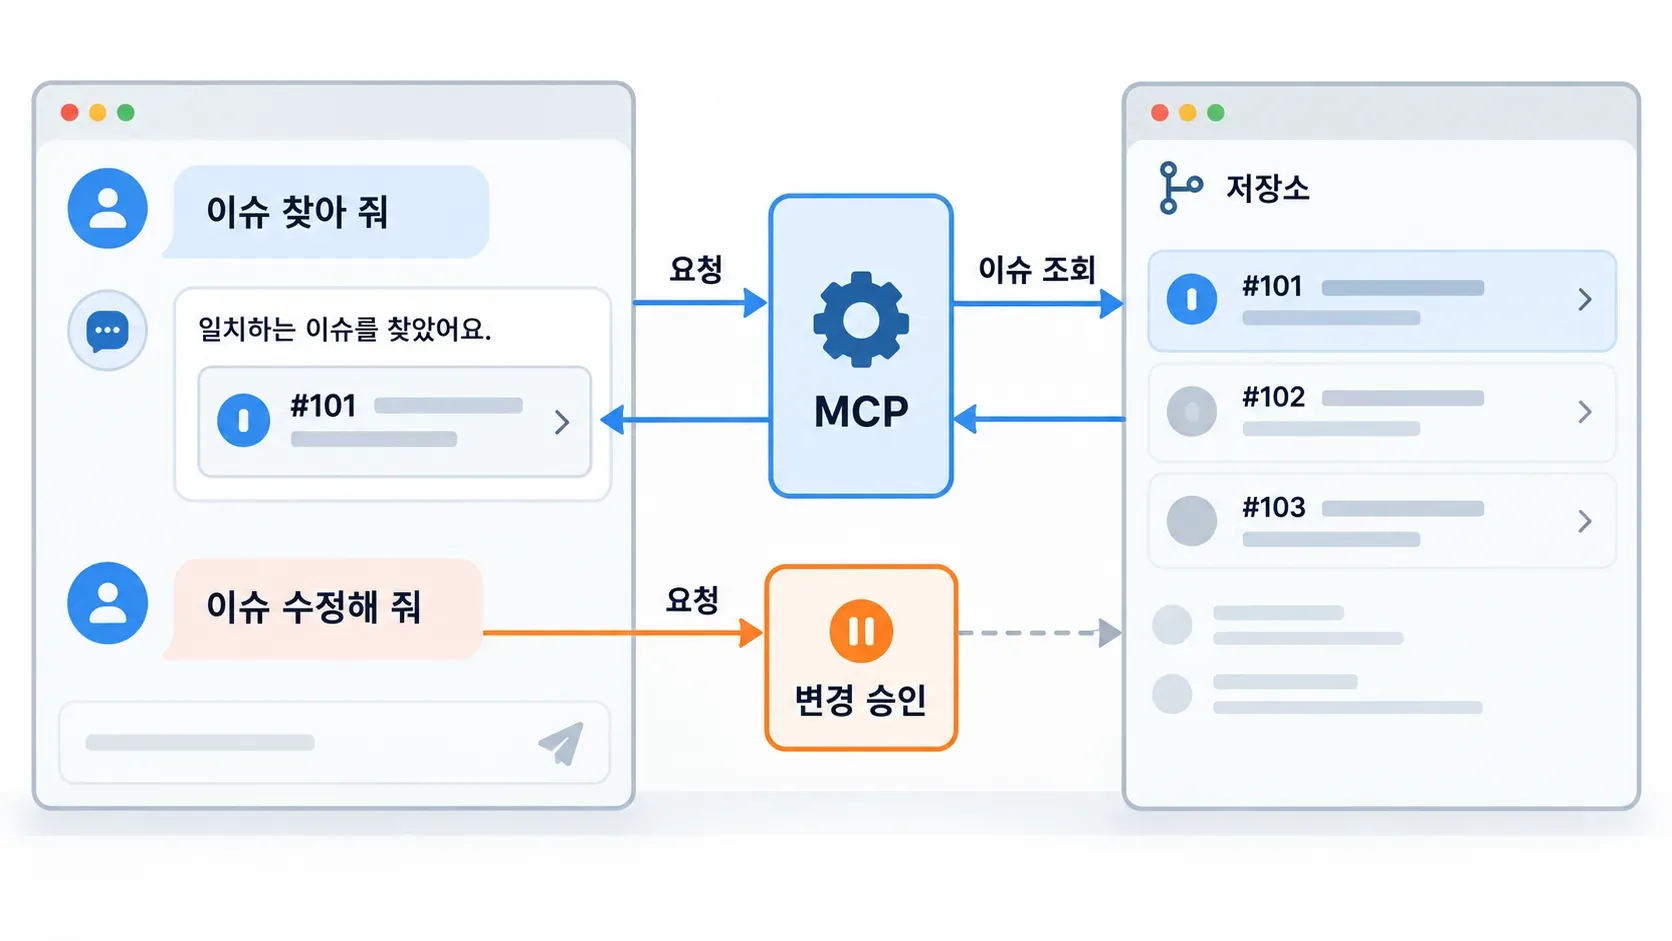
MCP를 연결하면 이 왕복의 일부를 에이전트에게 맡길 수 있습니다. 허용된 데이터 구조를 확인하고, 도구로 조회하고, 실제 결과를 받아 다음 질문이나 수정안을 만드는 흐름입니다. 브라우저에서는 화면 조작과 확인을, 영상 서비스에서는 기획한 컷의 생성 요청을 같은 대화에서 이어갈 수 있습니다. 자연어가 작업의 입구가 되고, 연결한 도구가 실행 범위를 정합니다.
저도 MSSQL MCP를 사용해 봤습니다. SQL Server를 다루는 개발 업무는 MCP의 활용을 설명하기 좋은 출발점입니다. 여기서 브라우저 검증과 영상 제작으로 범위를 넓히면 같은 연결 방식이 서로 다른 일을 어떻게 돕는지 볼 수 있습니다.
MCP가 줄이는 것은 질문과 실행 사이의 왕복입니다
MCP의 공식 구조 설명은 사용자가 대화하는 호스트, 연결을 관리하는 클라이언트, 외부 기능을 제공하는 서버를 구분합니다. SQL MCP 서버는 SQL을 이해하는 모델 그 자체가 아니라 데이터베이스 탐색·조회 같은 기능을 도구로 제공하는 쪽입니다. 모델은 요청과 도구 설명을 보고 호출을 결정하고, 돌아온 결과를 읽습니다.
연결하지 않은 AI에게 “우리 주문 구조에 맞는 SQL을 써 줘”라고 하면 구조를 모르는 상태에서 가정하거나 추가 자료를 요청해야 합니다. 연결된 도구가 있으면 허용된 테이블과 컬럼부터 확인할 수 있습니다. 쿼리가 실패했다면 실제 오류를 보고 고칠 수도 있습니다. 다만 도구를 호출하지 않고 상상한 결과를 답할 가능성까지 없어지는 것은 아니므로, 실행 SQL·호출 기록·실제 반환값을 함께 요구하는 습관이 중요합니다.
이 원리는 데이터베이스에만 해당하지 않습니다. Playwright는 웹 페이지 조작을, Higgsfield는 이미지·영상 생성 기능을 제공합니다. 연결 규약이 같아도 권한, 비용, 완료 확인 방법은 서로 다릅니다. MCP의 연결·보안 구조를 이해했다면 이제는 서버 이름보다 줄이고 싶은 작업부터 고르는 편이 쉽습니다.
SQL MCP로 데이터베이스 작업을 연결합니다
SQL Server를 연결하는 MSSQL MCP, PostgreSQL을 연결하는 MCP처럼 데이터베이스 작업을 돕는 MCP는 여러 가지가 있습니다. 테이블 구조를 살펴보고 쿼리를 실행하거나, 자주 쓰는 조회를 도구로 제공하는 데 활용할 수 있습니다. 여기서는 SQL Server에서 쓸 수 있는 DBHub와 Microsoft의 SQL MCP Server를 예로 들어 보겠습니다.
Bytebase의 DBHub는 SQL Server를 포함한 여러 데이터베이스를 지원합니다. 스키마를 탐색하는 search_objects와 SQL을 실행하는 execute_sql을 제공하므로, 개발자가 구조를 조사하고 쿼리 후보를 만들며 데이터를 확인하는 사례에 맞습니다. SQL 실행 문서에는 DDL 작업도 설명돼 있지만, 읽기 전용 설정과 실제 DB 계정 권한이 이를 허용할 때만 실행할 수 있습니다. Microsoft가 제공하는 서버와는 별개의 프로젝트입니다.
또 다른 예로 Microsoft의 SQL MCP Server는 Data API builder를 기반으로, 설정에 등록한 테이블·뷰·저장 프로시저를 정해진 도구로 다루는 방식입니다. 임의의 자연어를 자유로운 SQL로 바꾸는 방식과 테이블 구조를 생성·변경하는 DDL을 지원 대상으로 삼지 않습니다. 운영 업무에 필요한 기능을 좁혀 제공하려는 경우에 잘 맞는 접근입니다.
| 구분 | 역할 | 설명 | 예시 |
|---|---|---|---|
| SQL 탐색·실행 | SQL Server에 연결한 DBHub | 구조를 탐색하고 SQL을 작성해 실행합니다. 새 쿼리 분석과 데이터 디버깅에 활용할 수 있습니다. | 여러 환불이 있는 주문의 중복 집계 원인 조사 |
| 허용된 업무 도구 | Data API builder 기반 SQL MCP Server | 등록된 엔터티와 허용된 동작을 선택합니다. 승인한 조회·집계·프로시저를 반복 호출하는 방식입니다. | 미리 정의한 매출 조회 뷰·프로시저 사용 |
| 설계 초안과 적용 | 모델의 제안과 실행 권한을 구분 | 기존 구조로 DDL 초안을 제안받을 수 있어도, 실행 가능한 서버인지와 DB 권한은 별도로 확인해야 합니다. | Microsoft SQL MCP Server는 DDL을 담당하지 않음 |
Microsoft 문서의 read_records는 한 테이블이나 뷰를 조회하는 도구입니다. 여러 테이블을 결합해야 한다면 조회용 뷰나 프로시저로 그 관계를 먼저 정의합니다. 복잡한 관계는 미리 검토한 뷰나 매개변수가 있는 저장 프로시저로 제공할 수 있습니다. 집계 도구의 제공 여부도 설치 버전에 따라 확인해야 합니다. 같은 “지난달 매출” 질문이라도 한쪽은 SQL을 만드는 작업이고, 다른 쪽은 이미 정의한 매출 조회 도구를 사용하는 작업입니다.
자연어로 매출을 묻되, 집계 기준부터 함께 정합니다
가상의 쇼핑몰 SQL Server에 Orders와 Refunds가 있다고 하겠습니다. 주문 한 건에 부분 환불이 여러 번 발생할 수 있는 구조입니다. 예전에는 사람이 스키마를 찾아 JOIN을 작성하고 오류를 고치며 결과를 비교했다면, SQL MCP를 연결한 뒤에는 그 탐색과 수정 과정을 대화로 지시할 수 있습니다.
처음부터 “매출 하락 원인을 분석해”라고만 요청하면 기간, 취소 처리, 집계 단위가 섞이기 쉽습니다. 다음처럼 작업 조건을 주는 편이 검수하기 좋습니다.
분석용 SQL Server에서 주문과 환불에 관련된 테이블·컬럼을 먼저 찾아 줘.
고객 이름·연락처는 읽지 말고, 주문 식별자와 집계에 필요한 필드만 사용해.

8월 결제 완료 주문의 현재까지 확정된 환불을 차감하는 기준으로 볼 거야.
이 기준과 월별 회계 매출이 어떻게 다른지도 설명해 줘.
날짜 저장 시간대와 주문-환불 관계를 확인하고, SQL을 먼저 보여 줘.
조회 후에는 주문 수, 총 결제액, 환불액, 차감액을 함께 반환해.
표본 몇 건으로 중복 집계 여부를 점검하고 모르는 조건은 질문해 줘.
DBHub의 스키마 탐색 도구는 테이블·컬럼·인덱스 등의 정보를 필요한 범위에서 찾도록 구성돼 있습니다. 모든 테이블 전체를 한 번에 가져오기보다 관련 이름부터 찾고, 필요한 객체의 상세 구조로 내려가는 방식이 적절합니다. 검색 결과가 비어 있다고 해당 데이터가 반드시 없는 것은 아닙니다. 스키마 이름, 검색 패턴, 연결 계정이 볼 수 있는 범위를 먼저 확인해야 합니다.
주문과 환불을 바로 JOIN하면 왜 숫자가 커질까요
주문 금액이 10만 원인 주문에 환불 행이 두 개 있으면, 단순 JOIN 결과에는 같은 주문 금액이 두 번 나타날 수 있습니다. 그 상태에서 주문 금액을 합산하면 20만 원이 됩니다. SQL 문법이 맞고 실행이 성공해도 분석은 틀린 셈입니다.
아래는 이 관계를 설명하기 위한 T-SQL 예시입니다. PaidAt이 업무 기준 시간대로 저장되고, PaidAmount가 주문별 최초 결제액이며, 환불은 확정 상태만 합산한다는 가정입니다. 실제 테이블·상태값에 그대로 실행할 쿼리가 아닙니다.
DECLARE @Start datetime2 = '2026-08-01T00:00:00';
DECLARE @End   datetime2 = '2026-09-01T00:00:00';

WITH RefundByOrder AS (
    SELECT OrderId, SUM(Amount) AS RefundAmount
    FROM dbo.Refunds
    WHERE Status = 'Settled'
    GROUP BY OrderId
)
SELECT
    COUNT_BIG(*) AS OrderCount,
    SUM(o.PaidAmount) AS GrossAmount,
    SUM(COALESCE(r.RefundAmount, 0)) AS RefundAmount,
    SUM(o.PaidAmount - COALESCE(r.RefundAmount, 0)) AS NetAmount
FROM dbo.Orders AS o
LEFT JOIN RefundByOrder AS r ON r.OrderId = o.OrderId
WHERE o.PaidAt >= @Start AND o.PaidAt < @End
  AND o.PaymentStatus = 'Paid';
핵심은 환불을 주문당 한 행으로 먼저 모으는 것입니다. 이 예시는 8월 결제 주문을 묶고 그 주문의 확정 환불을 현재 상태로 차감하므로, 9월에 처리된 환불도 포함될 수 있습니다. 8월 말 시점의 마감 수치를 원한다면 환불 확정 시점과 상태 이력을 추가로 따져야 합니다. “지난달 매출”이라는 짧은 말에서 이런 기준까지 AI가 알아서 맞췄다고 가정하면 안 됩니다.
결과를 받은 다음에는 “숫자를 설명해”에 그치지 말고, 환불 없는 주문·부분 환불 주문·여러 번 환불한 주문을 각각 골라 계산을 대조하도록 요청할 수 있습니다. 빈 결과와 0원, 일부 행만 반환된 결과와 전체 집계를 구분하고, 월 경계·중복 키·통화·세금 포함 여부를 확인해야 합니다.
쿼리 성능도 같은 방식으로 검토할 수 있습니다. 긴 JOIN의 역할을 풀어 쓰게 하고, 필요한 인덱스 후보와 그 근거를 제안받은 뒤 실제 실행 계획과 측정값을 확인하는 흐름입니다. 다만 실행 계획 도구의 지원 여부와 DB 권한은 별도입니다. AI가 “인덱스를 추가하면 빨라진다”고 제안한 것과, 실제 부하에서 성능이 개선된 것은 다른 결과입니다.
테이블 설계는 기존 구조를 이해하는 데서 시작합니다
SQL MCP가 유용한 또 다른 지점은 신규 기능의 설계 초안입니다. 예를 들어 정기 구독 기능을 추가할 때 기존 고객·상품·결제 테이블을 읽고, 구독 상태와 청구 이력을 어디에 둘지 제안받을 수 있습니다. 연결 없이 설계하면 이미 존재하는 고객 키나 결제 이력을 중복해서 만들기 쉽지만, 기존 구조를 제공하면 그 구조와 맞물리는 초안을 검토할 수 있습니다.
기존 고객·상품·결제 구조를 읽고 정기 구독 기능의 테이블 설계안을 만들어 줘.
이번 작업은 설계 검토만 하고 CREATE·ALTER·DROP은 실행하지 마.

구독의 현재 상태와 월별 청구 이력을 분리하고,
중복 청구 방지 키, 금액 정밀도, 시간대, 해지 후 보존할 이력을 설명해 줘.
ER 관계, SQL Server용 DDL 초안, 기존 데이터 이관 순서를 각각 제시해.
실패 시 되돌릴 방법과 되돌릴 수 없는 변경도 표시해 줘.
여기서 먼저 받을 산출물은 테이블 개수가 아니라 설계 이유입니다. “한 고객이 여러 구독을 가질 수 있는가”, “요금제 가격이 바뀌어도 과거 청구액이 유지되는가”, “외부 결제 이벤트가 재전송돼도 중복 반영되지 않는가”를 답해야 합니다. 기본키·외래키·유일성 제약과 조회 패턴에 맞는 인덱스는 그 답을 구조로 옮기는 수단입니다.
AI가 DDL을 작성하는 데에는 운영 DB 쓰기 권한이 필요하지 않습니다. 읽기 범위의 자료로 초안을 만들고, 별도의 테스트 DB에서 검토한 마이그레이션을 실행한 뒤 데이터 보존과 애플리케이션 호환성을 확인할 수 있습니다. Microsoft SQL MCP Server가 DDL을 다루지 않는다는 사실도 이 흐름과 모순되지 않습니다. 설계를 제안하는 모델의 역할과, 적용을 실행하는 서버의 역할을 나누면 됩니다.
SQL 연결은 작은 읽기 범위부터 시작합니다
첫 연결에는 분석용 복제본이나 민감한 컬럼을 제외한 뷰가 적당합니다. MCP를 위한 DB 계정에 필요한 조회 권한만 부여하고, 서버 주소·DB 이름·인증 방식·TLS·네트워크 접근 조건을 확인합니다. 로컬 MCP 서버를 실행해도 조회 결과가 대화 중인 모델 서비스로 전달될 수 있으므로, 로컬 연결을 데이터의 외부 전송 금지와 동일하게 생각해서는 안 됩니다.
다음은 DBHub의 TOML 설정 문서를 바탕으로 구성한 예시입니다. MSSQL_MCP_DSN에는 별도로 준비한 SQL Server 연결 문자열을 환경변수로 전달해야 합니다. 예시에 비밀번호를 넣어 공유하지 않습니다.
[[sources]]
id = "analytics"
dsn = "${MSSQL_MCP_DSN}"

[[tools]]
name = "search_objects"
source = "analytics"

[[tools]]
name = "execute_sql"
source = "analytics"
readonly = true
max_rows = 100
사용하는 MCP 클라이언트에 서버 실행 명령과 이 설정 파일의 절대 경로를 등록합니다. DBHub 명령행 안내의 --config를 사용하고, 조직에서 검토한 패키지 버전을 고정하는 편이 재현하기 쉽습니다. 클라이언트가 서버를 시작하는 방식이라면 그 프로세스에 환경변수도 전달돼야 합니다. 터미널에만 설정하고 앱을 따로 실행하면 인증 정보를 읽지 못할 수 있습니다. 연결 문자열과 설정 전체를 채팅에 붙여 넣어 진단하지는 마세요.
readonly = true와 행 수 제한은 보조 통제입니다. SQL Server 계정 자체의 권한까지 제한하고, 첫 요청은 “허용된 테이블 이름만 보여 줘”로 좁혀야 합니다. DBHub 문서도 최소 권한 DB 사용자를 권고합니다. 반환 행이 100개로 잘렸다면 그것을 전체 데이터 건수로 해석하지 않습니다. 조회 부하와 실행 시간은 별도로 관리해야 합니다.
연결 뒤에는 도구 목록, 보이는 객체, 반환 필드, 결과 누락 여부를 순서대로 확인합니다. 도구가 보이지 않으면 클라이언트의 실행 설정부터, 테이블이 보이지 않으면 DB·스키마·권한부터 살펴봅니다. 숫자가 이상하면 재설치부터 할 것이 아니라 집계 기준과 JOIN 관계로 돌아가야 합니다. 엔터티·필드 설명을 쓰는 Microsoft 지침처럼 상태값의 의미, 금액 단위, 날짜 시간대를 설명해 두면 모델이 추측할 부분을 줄일 수 있습니다.
Playwright MCP: 클릭을 맡기고, 결과를 확인하게 합니다
Playwright MCP는 웹 페이지의 접근성 구조를 이용해 요소를 이해하고 조작하는 브라우저 자동화 서버입니다. SQL MCP가 데이터 구조를 살펴보게 한다면, 브라우저 MCP는 사용자가 거치는 실제 화면을 따라가게 합니다. 메뉴 이동, 폼 입력, 오류 재현 같은 탐색 업무에서 차이가 잘 드러납니다.
예를 들어 회원 설정 화면을 수정했다면 아래처럼 요청할 수 있습니다. 개발용 주소와 테스트 계정을 준비했다는 가정입니다.
테스트 환경의 프로필 수정 화면을 확인해 줘.
이메일을 비운 상태로 저장해 오류 안내가 보이는지 확인하고,
유효한 테스트 이메일로 바꾼 뒤 저장해 줘.
새로고침 후에도 값이 유지되는지 확인해 줘.

각 단계의 입력·관찰 결과·스크린샷을 남겨 줘.
화면의 성공 메시지만으로 저장됐다고 단정하지 마.
실제 회원 초대나 외부 메일 발송이 필요하면 그 단계 전에 멈춰 줘.
이 작업의 산출물은 “버튼을 눌렀다”가 아니라 빈 입력에서 오류가 나타났는지, 정상 입력이 반영됐는지, 새로고침 뒤에도 유지되는지에 대한 기록입니다. 실패가 재현되면 어떤 페이지·계정·입력에서 실패했는지 남겨 수정과 재확인을 이어갈 수 있습니다. 탐색으로 찾은 중요한 동작은 반복 실행 가능한 테스트 코드로 옮겨 회귀를 확인하는 편이 좋습니다.
브라우저 자동화가 모든 화면을 똑같이 읽는 것은 아닙니다. 로그인 상태, 팝업, 프레임, 접근성 정보가 빈약한 캔버스 화면 등은 별도 확인이 필요합니다. 테스트용 세션을 쓰고, 페이지에 보이는 문구를 에이전트의 상위 지시로 받아들이지 않도록 해야 합니다. 공식 저장소도 Playwright MCP 자체가 보안 경계는 아니라고 명시합니다.
도입할 때는 MCP가 항상 최선인지도 확인하세요. Playwright 공식 문서는 코딩 에이전트에서 CLI와 Skill 조합이 문맥 사용량 측면에서 더 적합할 수 있다고 안내합니다. 지속적인 브라우저 상태를 보며 탐색하는 작업은 MCP를 검토하고, 정해진 테스트를 자주 반복하는 작업은 테스트 러너·CLI와 함께 비교하면 됩니다.
Higgsfield MCP: 기획한 컷을 제작 요청으로 연결합니다
영상에서는 데이터 조회 대신 생성 작업이 연결됩니다. Higgsfield의 공식 MCP 안내는 기존 계정에 연결해 이미지·영상 등 제작 기능을 사용하는 방식이라고 설명합니다. 공식 서버 주소는 https://mcp.higgsfield.ai/mcp이며 OAuth로 연결합니다. 비슷한 이름의 비공식 서버와 구분해야 합니다.
예를 들어 머그컵을 소개하는 짧은 제품 영상을 만든다고 하겠습니다. 먼저 대상 고객과 핵심 메시지를 정하고, 제품 사진을 기준으로 컷 구성과 카메라 움직임을 작성합니다. 그다음 확정한 컷을 생성 요청으로 옮기고 결과를 검토합니다. Higgsfield의 마케팅 활용 안내가 보여 주는 연결의 가치는 기획 대화와 제작 도구 사이를 덜 오가게 한다는 데 있습니다.
첨부한 사용 권한이 있는 머그컵 사진을 기준으로 짧은 제품 영상의 컷을 기획해 줘.
손잡이 클로즈업, 책상 위 배치, 손으로 들어 올리는 장면을 제안해 줘.
컵의 색과 모양은 유지하고, 제품에 없는 성능 문구를 만들지 마.

먼저 컷별 목적·카메라 움직임·필요한 모델·예상 크레딧을 설명해 줘.
비용을 확인할 수 없으면 추정치를 확정 금액처럼 쓰지 마.
컷과 비용을 확인받은 뒤 첫 컷만 생성하고, 재생성도 별도 확인을 받아 줘.
이 예시에서 사람은 메시지와 컷을 정하고, 에이전트는 이를 제작 요청으로 구체화합니다. 생성 결과에서는 제품 모양, 장면 간 일관성, 손의 움직임, 글자 오류를 확인해야 합니다. 컷이 만들어졌다고 곧바로 납품 가능한 편집본이 완성된 것은 아닙니다. 필요한 조합·자막·오디오·검수 범위는 실제로 연결된 도구에 따라 달라집니다.
연결은 사용하는 에이전트에 맞춰야 합니다. 공식 연결 문서는 Claude의 커스텀 커넥터, ChatGPT의 공식 플러그인, CLI 기반 에이전트의 연결 경로를 따로 안내합니다. 따라서 모든 앱에 같은 JSON을 복사해 넣는 설명은 적절하지 않습니다. 유효한 구독과 인증을 준비하고, 첫 요청은 잔액 확인처럼 생성 비용이 들지 않는 확인 작업으로 시작할 수 있습니다.
비용 차이는 특히 중요합니다. Higgsfield의 크레딧 정책에 따르면 웹의 무제한·무료 생성 혜택은 MCP 같은 자동화 경로에 그대로 적용되지 않습니다. 연결된 에이전트에서 생성하면 크레딧이 차감됩니다. “이번 작업에서 일정 금액 이상 쓰지 마”라는 대화 지시는 서비스가 강제로 막는 한도와 다르므로, 실제 사용 내역과 재시도 횟수를 확인해야 합니다. 제품 사진·인물·음성의 이용 권한도 별도로 확보해야 합니다.
여러 MCP를 묶을 때는 넘기는 자료를 좁힙니다
세 종류를 함께 쓰면 제품 출시 작업을 연결할 수 있습니다. SQL MCP로 반응이 좋은 제품군을 집계하고, Playwright로 출시 페이지의 설명·버튼을 확인한 뒤, Higgsfield에서 공개용 영상 컷을 만드는 식입니다. 다만 SQL에서 얻은 고객별 거래 원장을 영상 서비스에 그대로 전달할 이유는 없습니다. 다음 단계에는 집계된 제품군 특성과 공개해도 되는 제품 설명만 넘기면 됩니다.
각 단계의 완료 기준도 다릅니다. SQL은 기준에 맞는 계산과 원장 대조, 브라우저는 실제 화면의 상태 변화, 영상은 의도한 컷과 사용량 확인이 기준입니다. 모든 도구를 연결해 한꺼번에 “출시해 줘”라고 요청하는 것보다, 중간 산출물을 확인하며 이어가는 편이 어느 단계에서 결과가 달라졌는지 찾기 쉽습니다.
첫 MCP는 검수할 수 있는 반복 업무로 고르세요
- SQL 분석스키마 확인과 쿼리 결과 복사를 반복한다면, 제한된 분석 DB에서 SQL 탐색·조회부터 시작합니다.
- 브라우저 검증같은 화면과 입력을 반복 확인한다면, 테스트 계정으로 오류 재현과 상태 확인을 맡깁니다.
- 영상 제작기획한 컷을 생성 도구에 반복 입력한다면, 첫 컷과 비용을 검토하며 제작 연결을 시험합니다.
SQL을 몰라도 질문을 시작하기는 쉬워집니다. 그렇지만 좋은 질문에는 집계 기준이 필요하고, 좋은 테이블에는 데이터가 변해도 유지돼야 할 규칙이 필요합니다. 브라우저에서는 클릭 뒤 상태를, 영상에서는 생성 뒤 품질과 비용을 읽을 수 있어야 합니다. MCP가 줄여 주는 것은 이 기준을 없애는 일이 아니라, 기준에 맞춰 도구를 오가며 확인하는 반복 작업입니다.
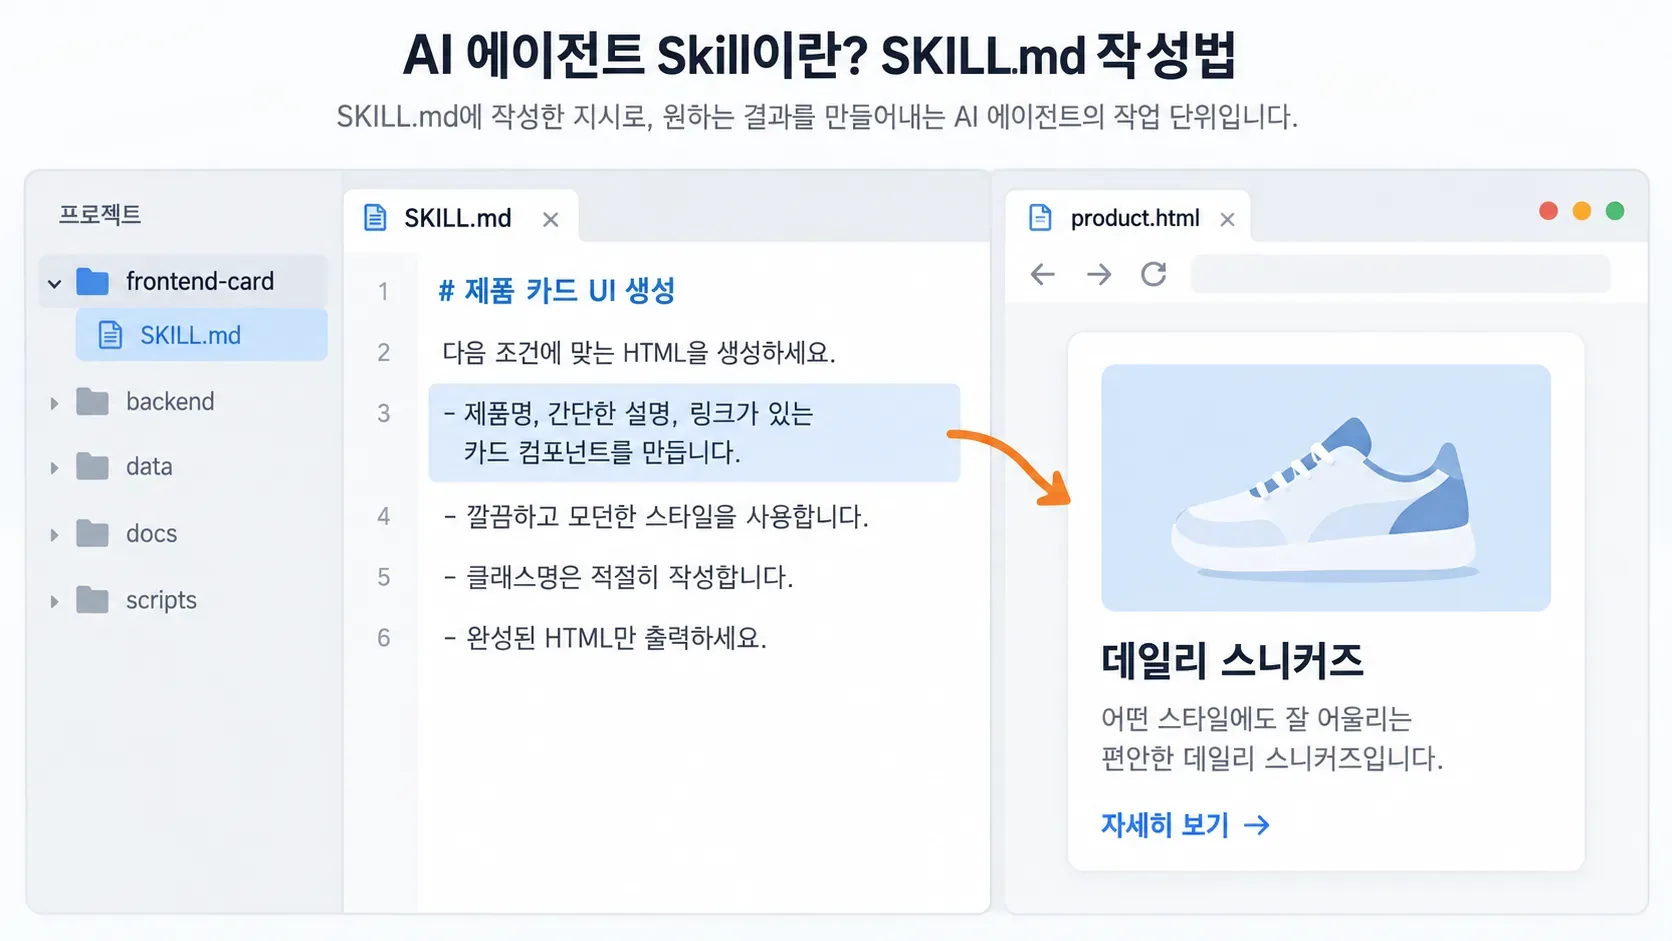
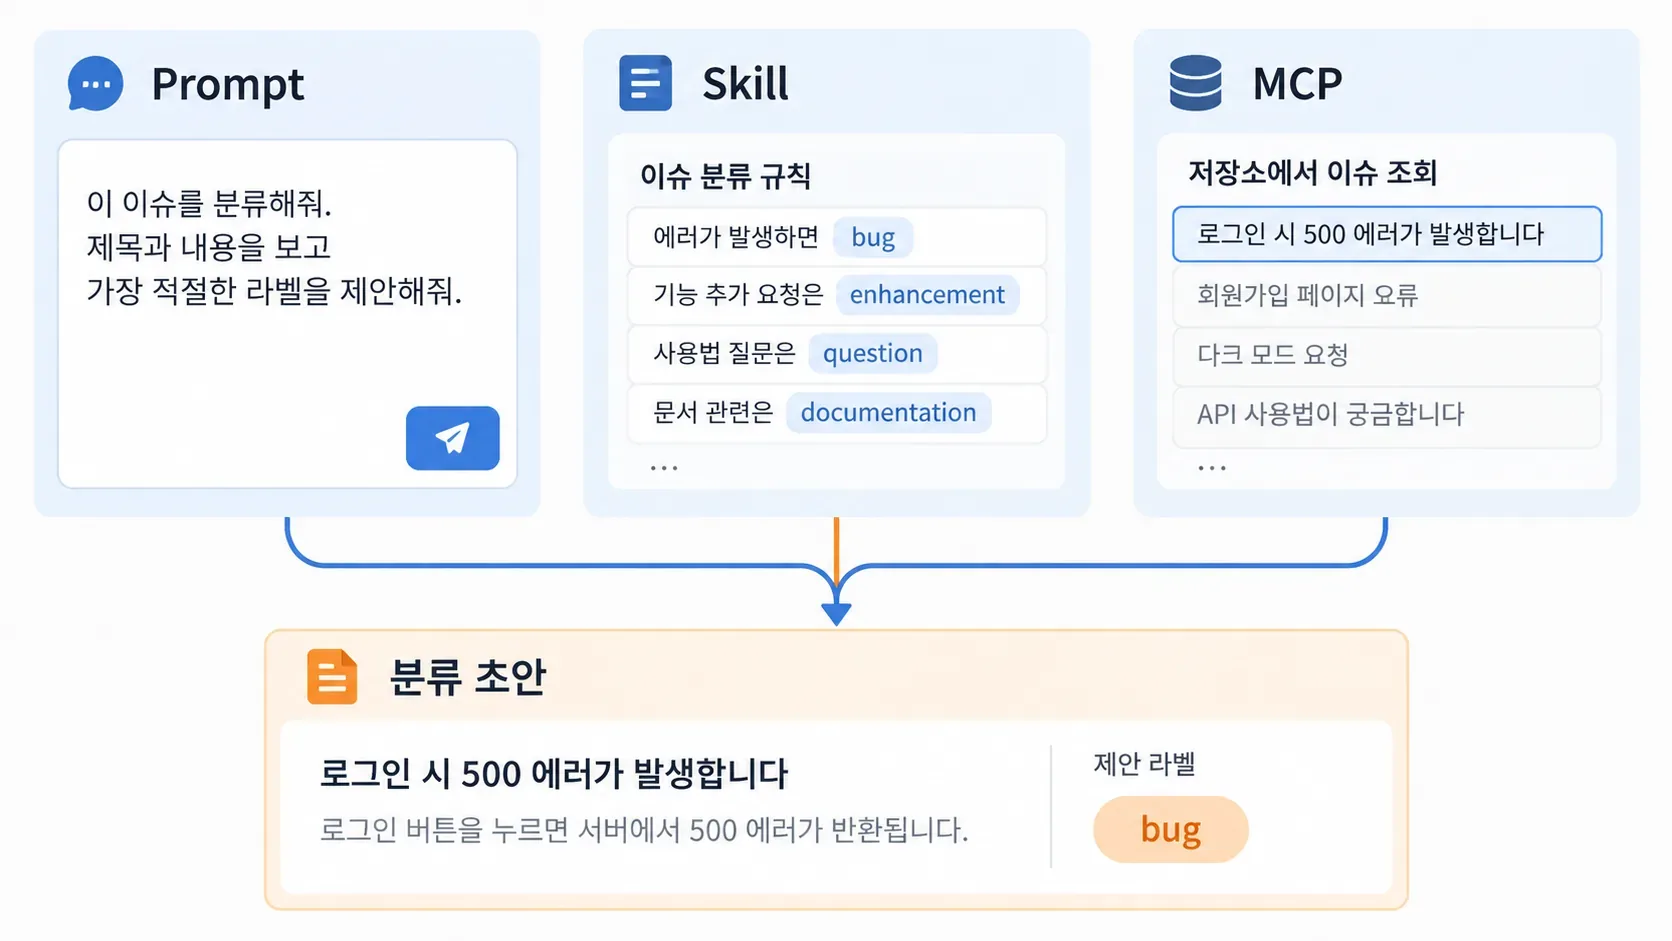
먼저 한 가지 업무에서 입력·허용 범위·완료 증거를 정해 보세요. 만족스러운 절차가 반복되면 Skill로 작업 방식을 정리하고, 외부 도구 연결은 MCP로 유지할 수 있습니다. Prompt·Skill·MCP의 역할 차이처럼 각각을 필요한 자리에 두는 것이 오래 쓰기 좋은 자동화의 출발점입니다.
VIEW—