
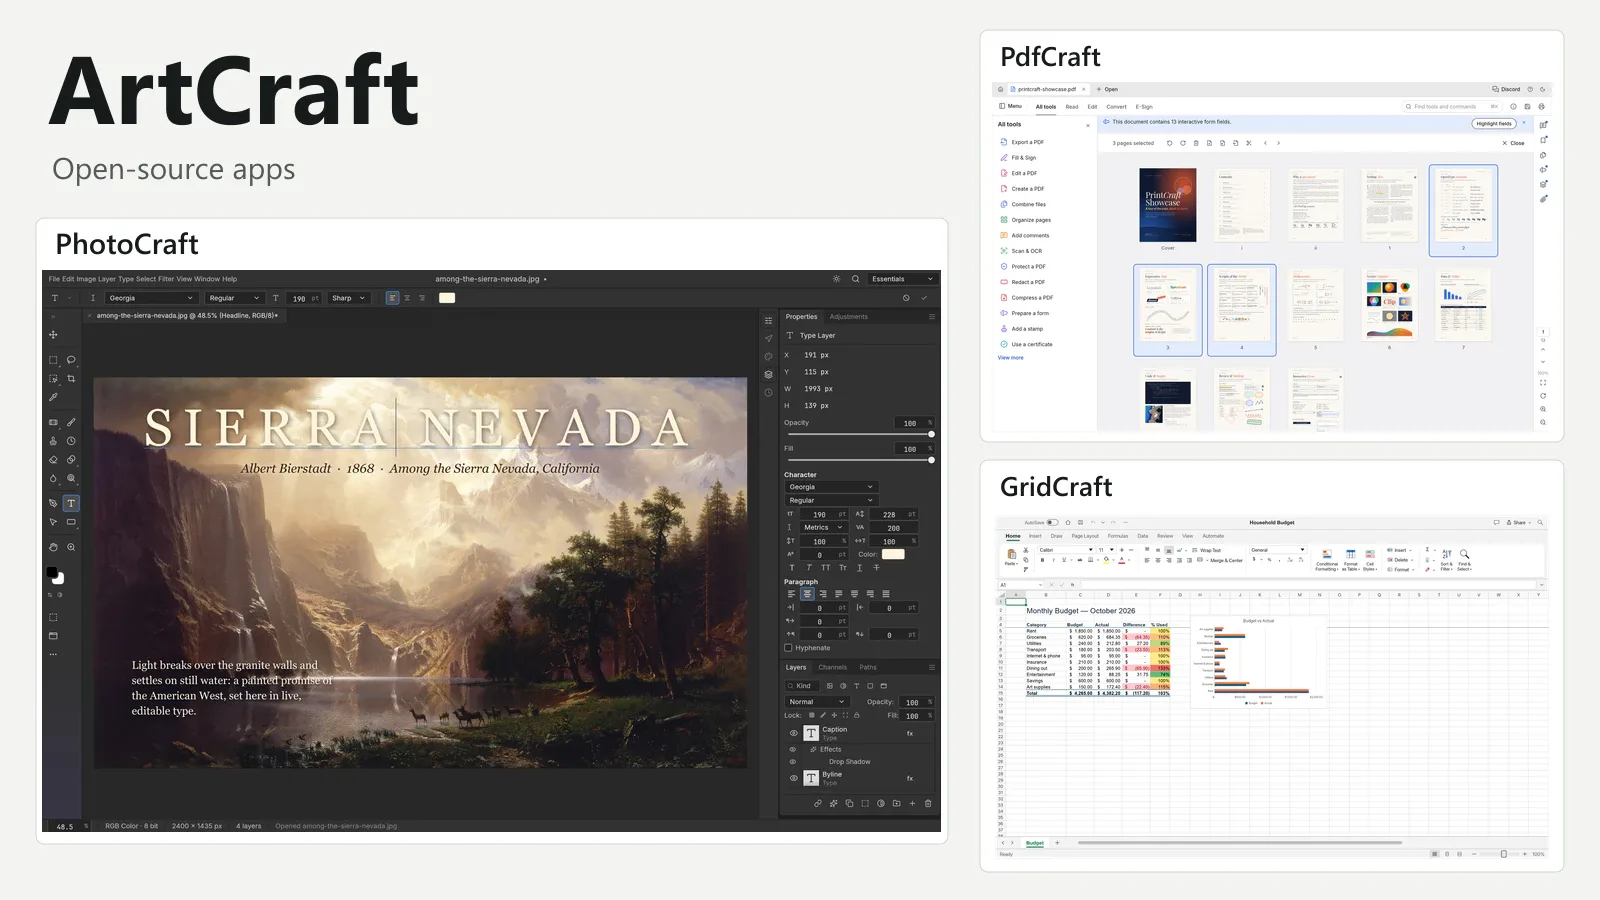
Adobe 앱들을 무료로? 포토샵 대안 PhotoCraft와 ArtCraft 앱들
ArtCraft의 이미지·PDF·벡터·영상·사진·문서 도구를 용도와 한계로 살펴봅니다. PhotoCraft를 대표 사례로 파일 호환성, 업데이트와 커뮤니티 반응을 짚고, CLI 자동화와 AI를 통한 기능 수정의 범위도 설명합니다.
Archive
AI를 시작으로 기술과 시장의 변화를 탐구하며, 지금과 언젠가의 쓰임이 될 지식과 인사이트를 기록합니다.
ArtCraft의 이미지·PDF·벡터·영상·사진·문서 도구를 용도와 한계로 살펴봅니다. PhotoCraft를 대표 사례로 파일 호환성, 업데이트와 커뮤니티 반응을 짚고, CLI 자동화와 AI를 통한 기능 수정의 범위도 설명합니다.
REA의 작동 방식과 공식 분석 사례를 살펴보고 GTA 재구현 주장을 확인합니다. 로컬 실행의 한계, 저작권 쟁점과 기업 대응을 통해 개발자가 확인할 기준을 정리합니다.
OpenAI의 수학 원고 공개를 둘러싼 반론을 원문으로 살펴봅니다. Lean 검증·원고 철회·검토 책임·인간의 이해를 구분하고 AI의 수학 성과를 읽는 기준을 설명합니다.
GPT-6.1 Sol과 Astra의 성능·사용 한도·API 가격을 비교합니다. 게임·앱 제작 사례와 함께 Sol로 구현하고, 막히는 문제와 초기 계획에 Astra를 활용하는 기준을 설명합니다.
촤컬릿의 부분 환불 사례로 RAG 검색에 필요한 의미·필터·계산을 구분합니다. turbopuffer가 ANN 중심 저장 구조를 바꾸는 이유와 v3 벤치마크의 해석 기준을 살펴봅니다.
메타 Muse의 수하물·장보기·가격 추적 활용 사례와 Grok Bot·OpenClaw의 차이를 살펴봅니다. 한국에서의 이용 조건과 네이버·카카오의 접근 제한, 작업을 맡기기 전에 확인할 권한과 결과를 정리합니다.
Git 3.0의 SHA-256 기본값 변경 계획이 새 저장소와 기존 이력에 미치는 영향을 구분하고, CI·호스팅·도구 호환성을 점검할 순서를 정리합니다.
Sonnet 5.5와 Opus 5.5를 같은 비용·목표 품질에서 비교합니다. 공식 벤치마크 그래프로 Low·Medium의 활용 범위와 높은 effort의 한계, 구현·검토 분업의 실제 비용을 살펴봅니다.
Jev 공개 16일 뒤 나온 Cloudflare Clef는 무엇이 다를까요? 고객 문의 분류로 작동 방식을 이해하고, Jev·Clef·Clef-flash의 성능·가격, 이미지 입력과 자체 운영 조건을 비교합니다.
Pi 1.0은 새 AI 모델이 아니라 모델과 도구를 조합하는 코딩 에이전트입니다. 같은 보고서 작업으로 Claude Code·Codex와 선택 기준을 비교하고, CodeMode·확장 기능이 필요한 조건과 모델 요금·실행 권한을 살펴봅니다.
모델이 좋아진 지금도 LangChain·LangGraph·LangSmith가 필요할까요? 영화 비유로 역할을 구분하고, SDK로 충분한 앱과 승인·복구·평가가 필요한 프로젝트의 도입 기준을 비교합니다.
모델이 스스로 수정·테스트하는데 별도의 루프와 그래프도 필요할까요? 기존 SDLC와의 차이, 도입이 과한 경우, 오류 조사·다중 저장소 작업의 적용 기준과 전체 비용을 살펴봅니다.
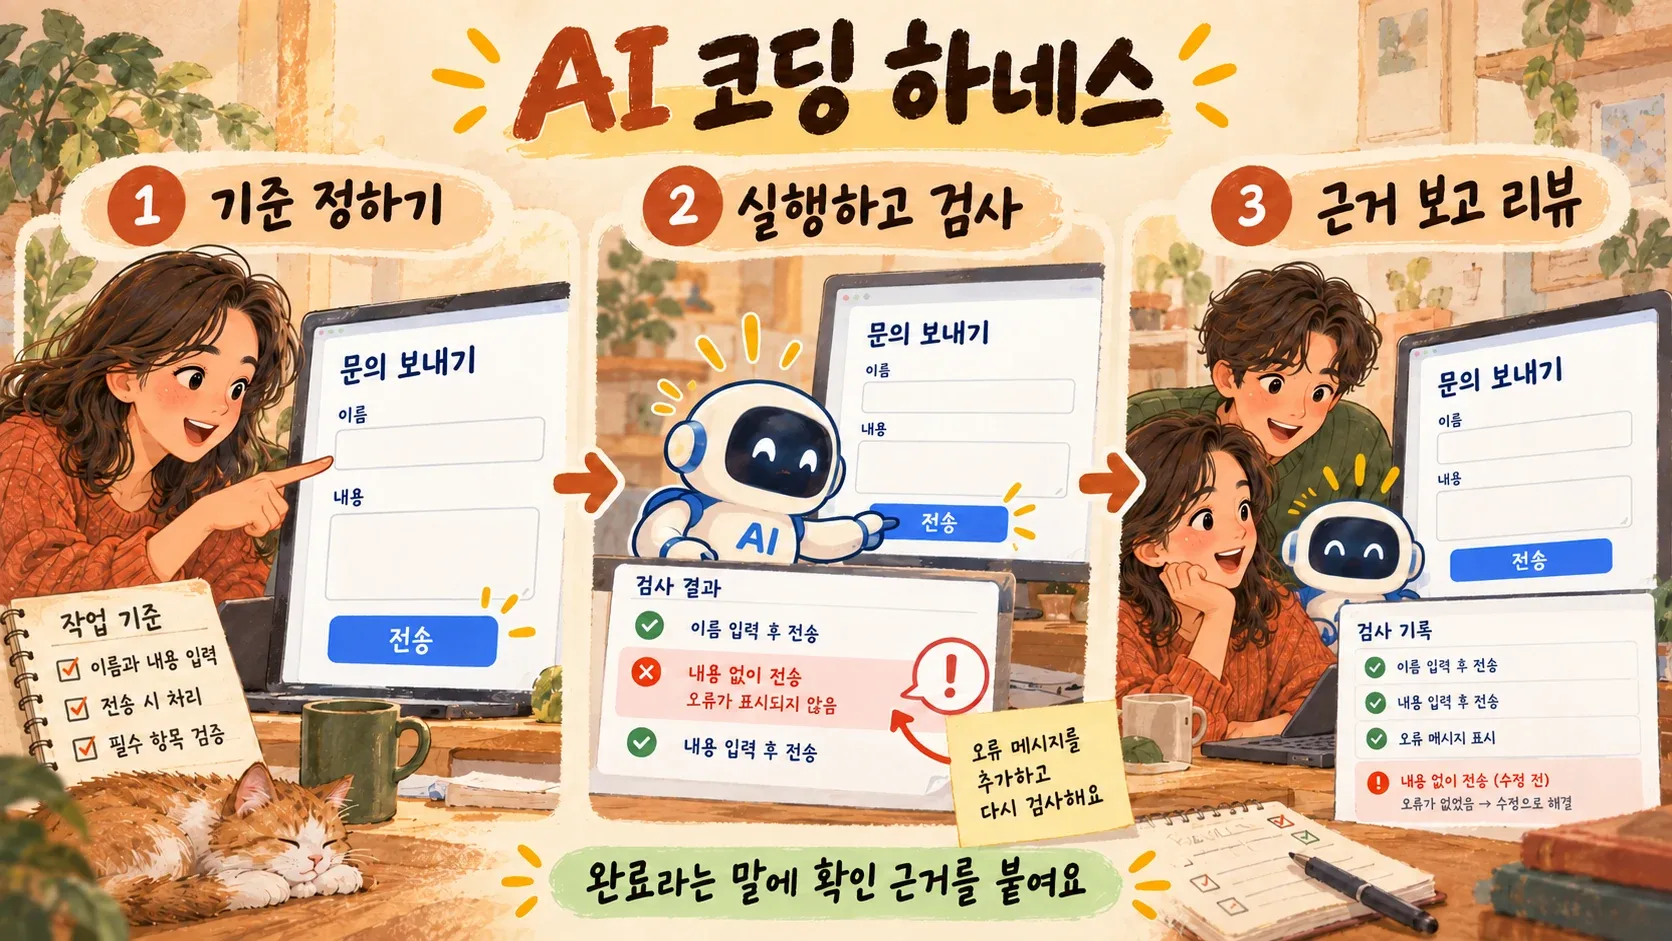
하네스 엔지니어링의 뜻과 프롬프트·컨텍스트 설계의 차이를 설명합니다. 문의 폼의 중복 접수·저장 실패 사례로 작업 범위, 테스트·CI, AI 코드 리뷰와 실패 후 재시작을 연결하는 방법입니다.
메모리 최적화와 100만 출력 토큰으로 주목받는 Gemini 4 Argon. 주요 성능, 경쟁 모델 대비 가격, 이용 가능 시점을 살펴봅니다.
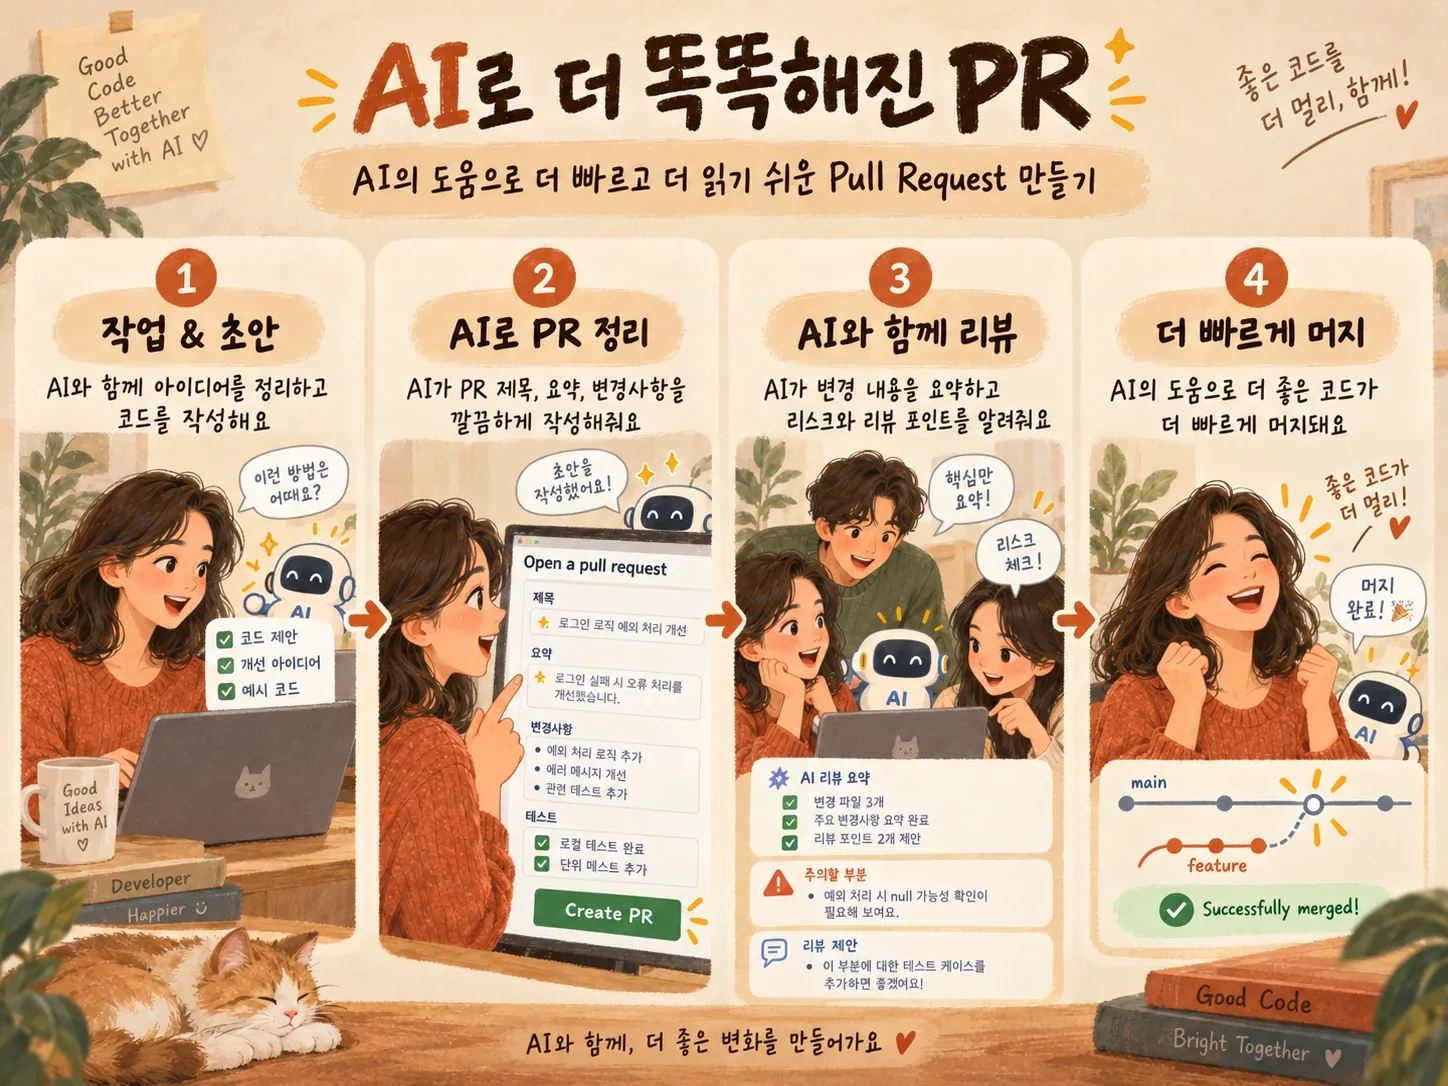
AI가 만든 코드의 PR 작성법과 리뷰 순서를 할 일 앱 예시로 설명합니다. 제목·설명·검증 기록을 쓰고, 기능별로 변경을 나누며, 동시에 진행할 PR 수와 CI·AI 리뷰 자동화 범위를 정하는 기준입니다.
OpenAI Dots를 ChatGPT에서 만들고 첫 업무를 맡기는 사용법입니다. 한국어 앱 화면으로 플러그인 연결과 반복 작업 예약을 살펴보고, 지원 요금제·컴퓨터 접근·중단 방법과 Grok Bot의 차이를 설명합니다.
챗GPT가 그럴듯한 오답을 만드는 이유와 답변 확인법입니다. 여행 일정과 회사 공지에서 원문의 대상·기한·예외를 대조하고, 근거를 찾지 못했을 때 보류하거나 답을 고치는 요청을 보여 줍니다.
챗GPT와 영어회화를 연습할 때 카페 점원 역할을 맡기고 한 문장씩 직접 답하는 방법입니다. 막히면 힌트를 받고 한 표현만 고쳐 다시 말하는 요청 예시와 연습을 마칠 때 확인할 부분을 보여 줍니다.
GPT-6 Sol·Luna와 Claude Opus 5.5의 발표 자료에서 가격과 업무 성능을 비교합니다. API 단가와 작업당 비용, 평가 조건을 구분하고 기존 모델에서 바꿀 때 확인할 선택 기준을 정리합니다.
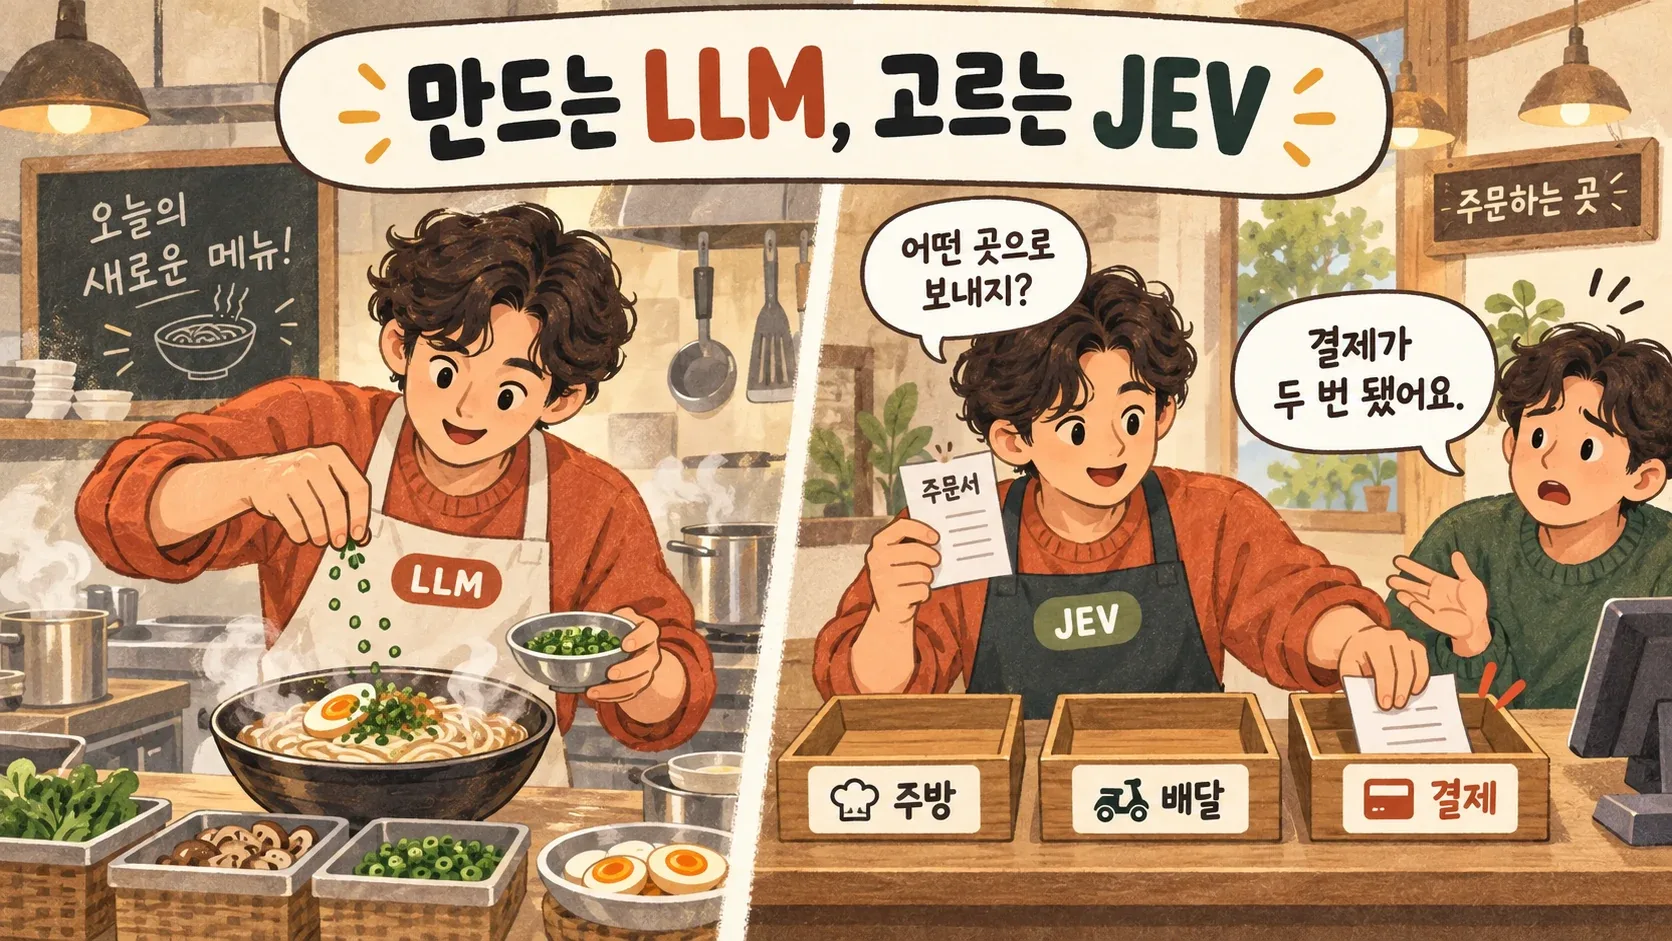
JEV와 LLM의 차이부터 Choice·Score·Noul, Playground와 TypeSafe API 사용법을 설명합니다. 고객 문의 분류 예시로 코드·의사결정 모델·LLM의 역할을 나누고 한국어 정확도와 비용을 확인하는 기준을 짚습니다.
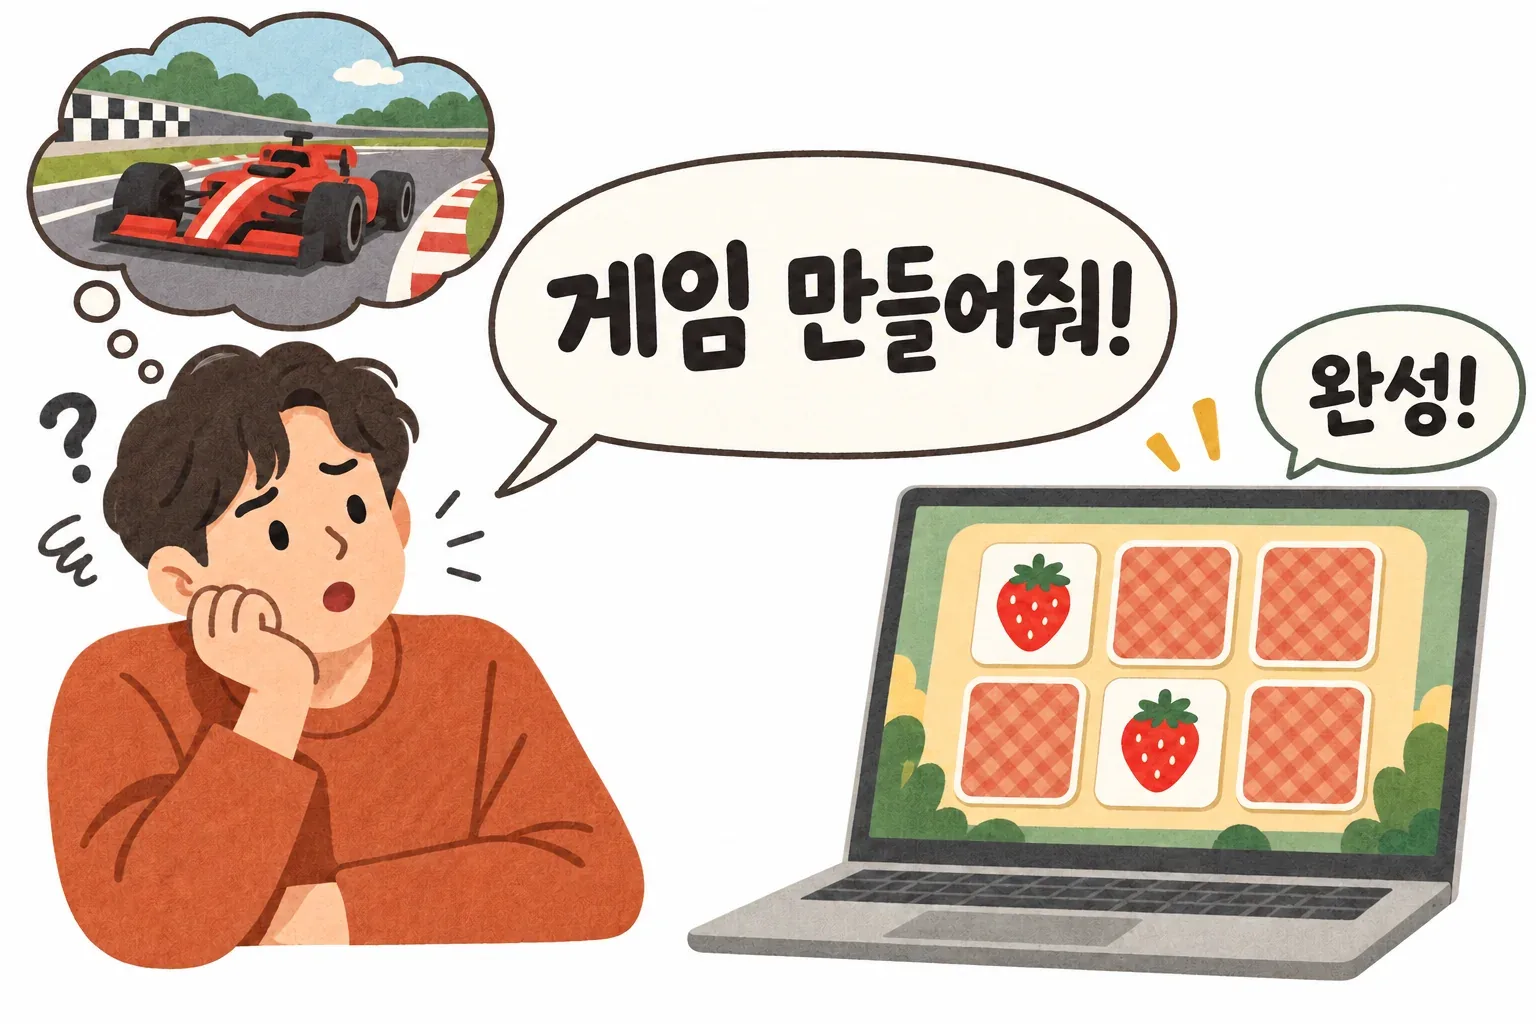
AI에게 블로그나 게임을 만들어 달라고 할 때 원하는 결과를 구체화하는 요청법입니다. 예시를 고르고 계획을 검토한 뒤 동작을 확인하는 대화로 LLM의 역할과 바이브코딩의 시작을 설명합니다.
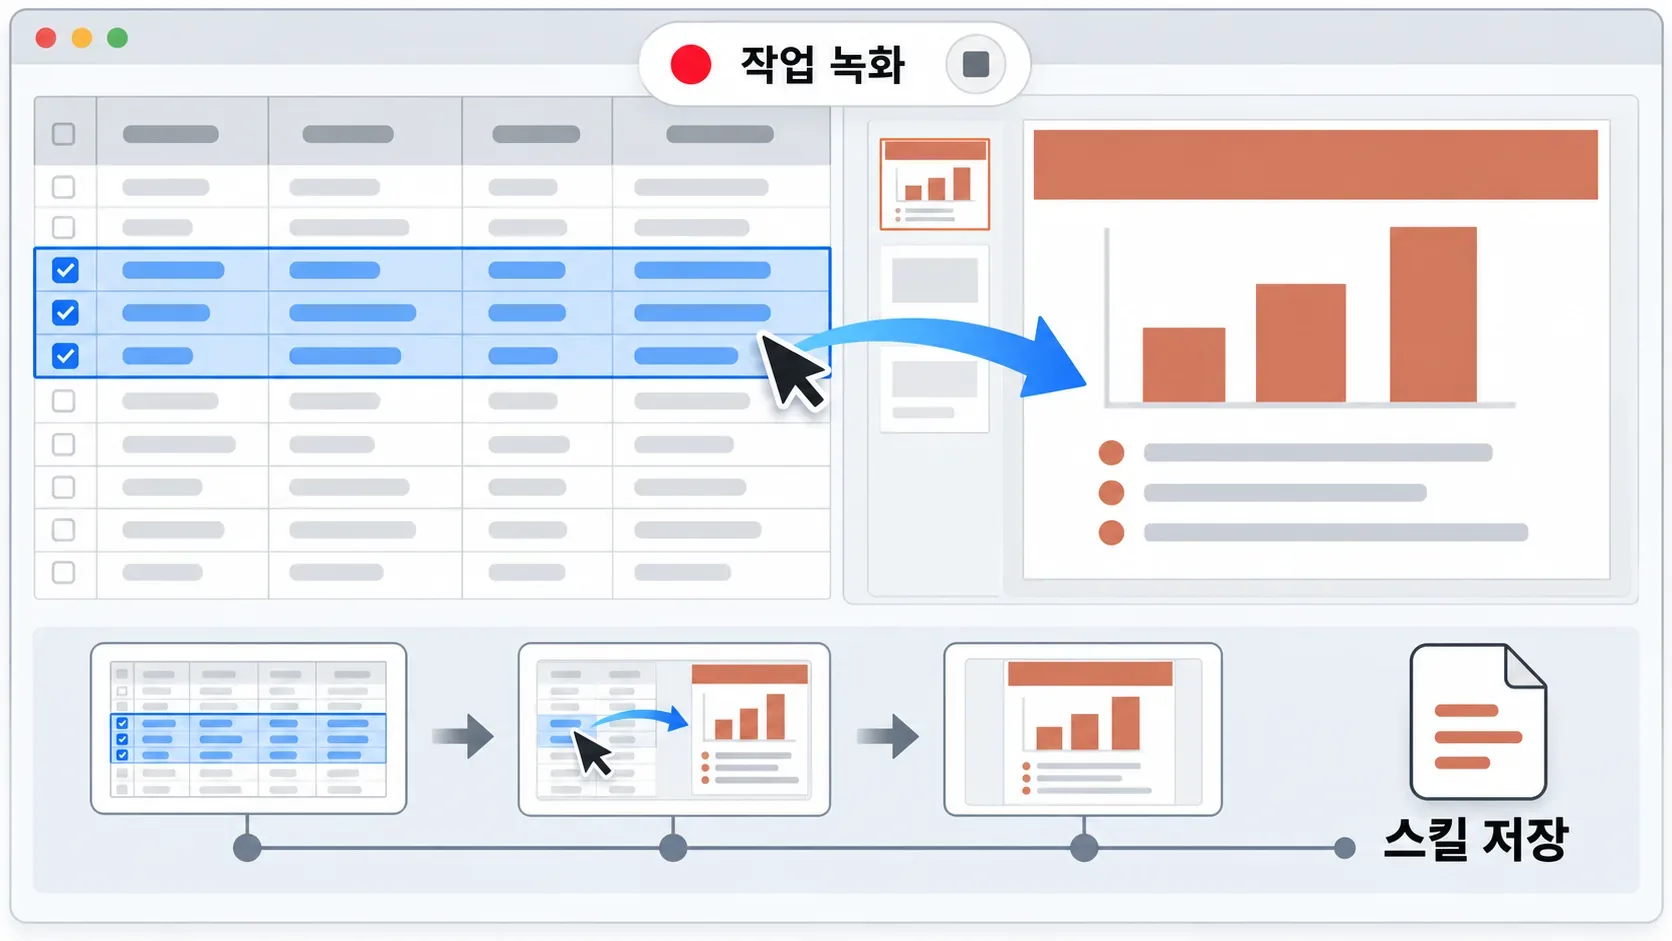
Claude 앱에서 반복 업무를 Skill로 정리하고 회사 PPT·Excel 양식을 재사용하는 방법입니다. 주간 보고서를 예로 작업 녹화, 양식 전달, 다음 실행 요청과 결과 수정 기준을 연결합니다.
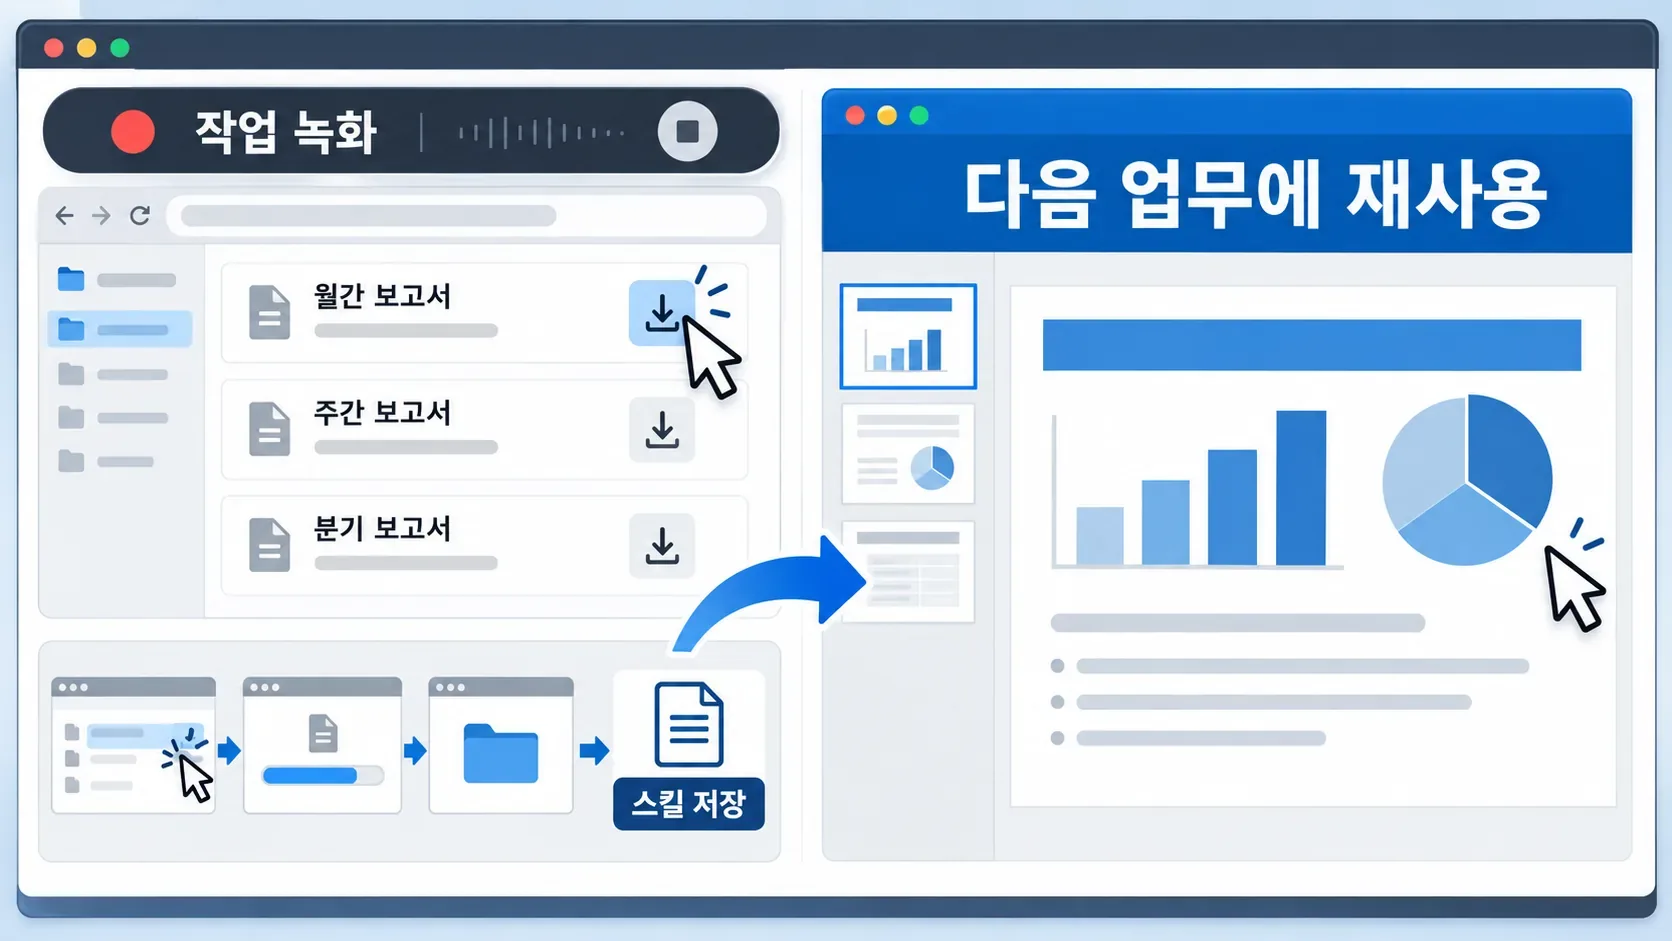
Codex 앱에 자료 조사부터 Excel 정리·PPT 작성·두 파일 대조까지 맡기는 방법입니다. 녹화한 절차와 회사 양식을 Skill로 연결하고, 다음에는 주제·기간·대상만 바꿔 요청하는 예시를 보여 줍니다.
Claude Code에서 긴 작업을 이어갈 때 컨텍스트와 토큰 사용을 관리하는 방법입니다. 결제 이벤트 예시로 작업 단위, compact·clear 선택, 상태 메모와 탐색 범위, CLAUDE.md·서브에이전트의 역할을 설명합니다.
Git worktree로 AI 코딩 작업 폴더를 나누고 Husky로 담당 범위 밖 커밋을 막는 방법입니다. 환경 분리와 CI·통합 검사, 결과 병합과 작업 폴더 정리까지 두 작업 예시로 설명합니다.
Grok Bot 설치·로그인부터 첫 업무 요청과 반복 실행까지 주간 보고서 예시로 따라갑니다. Windows·macOS·Linux·iPhone 시작 방법, 무료 체험과 사용량, 연결 권한·승인·결과 검토를 함께 설명합니다.
GPT-6 Astra의 컴퓨터 사용 시연과 공개 성능 평가를 읽는 방법입니다. 인간 인증 게임·피아노·그림판 사례와 벤치마크의 조건을 구분하고, 업무 위임과 AGENTS.md·스킬 점검에 필요한 기준을 짚습니다.
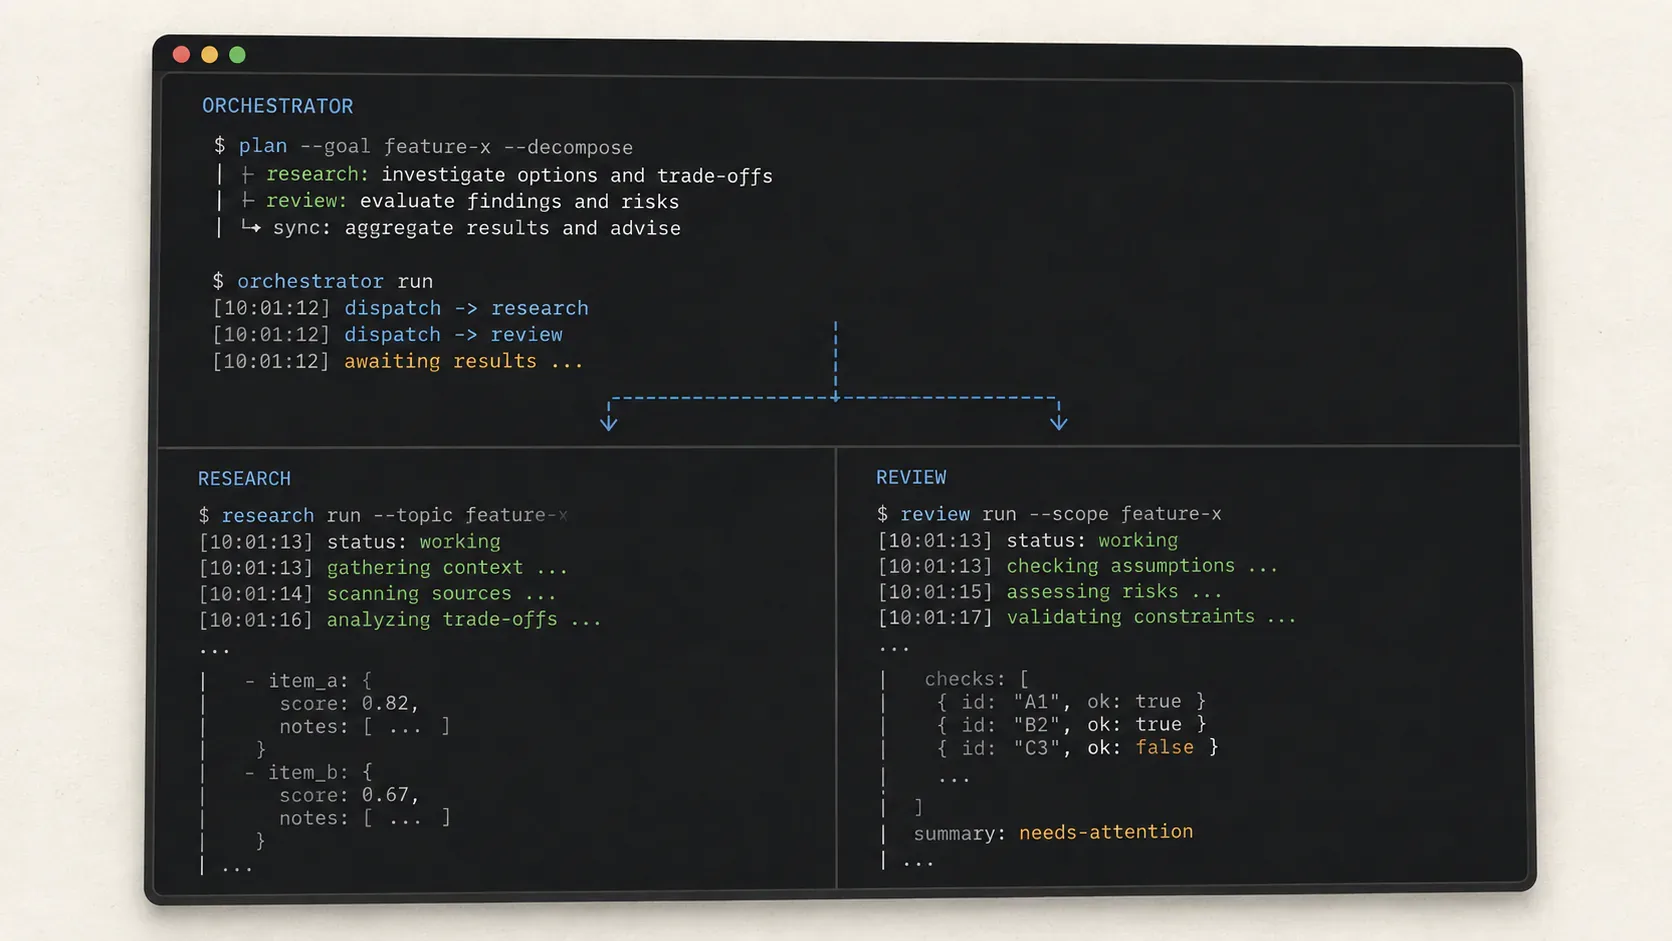
Herdr 설치 후 여러 AI 코딩 에이전트의 작업을 나누고 회수하는 사용법입니다. 실제 pane 구성과 상태값, 오케스트레이터의 확인 순서, 리뷰·테스트로 결과를 검증하는 운영 기준을 설명합니다.
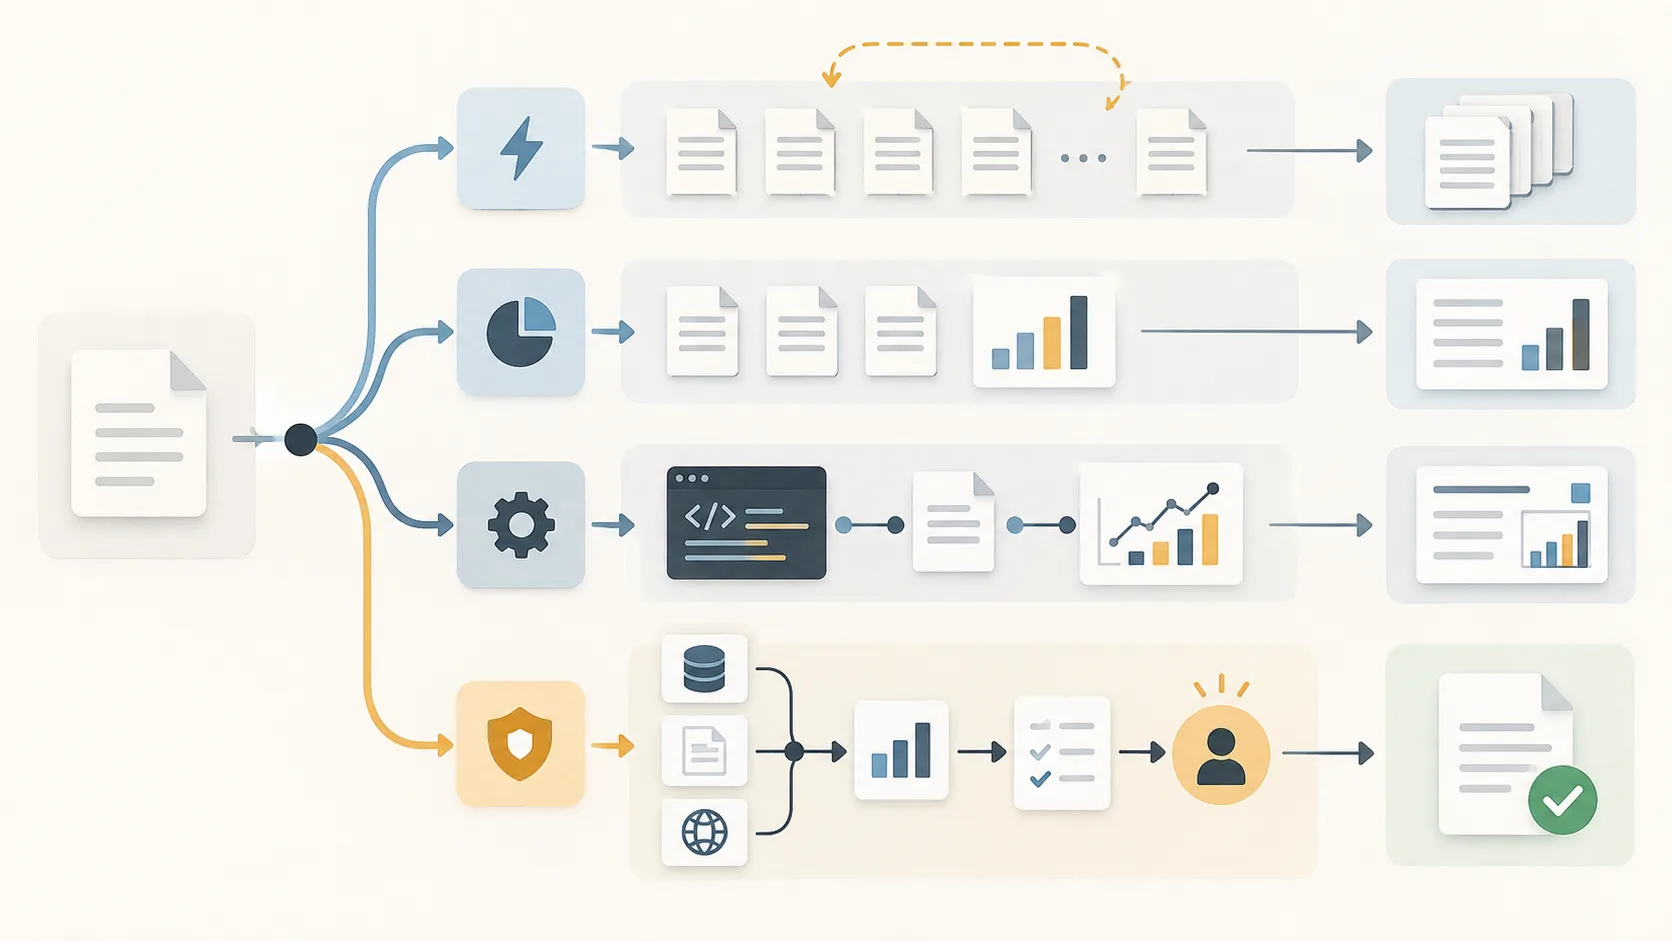
GPT-6 Astra와 GPT-5.6 Sol·Terra·Luna의 공식 가격과 공개 성능을 비교하고, 반복 업무·일상 고난도 업무·실패 비용이 큰 업무에 맞는 선택 기준을 정리합니다.
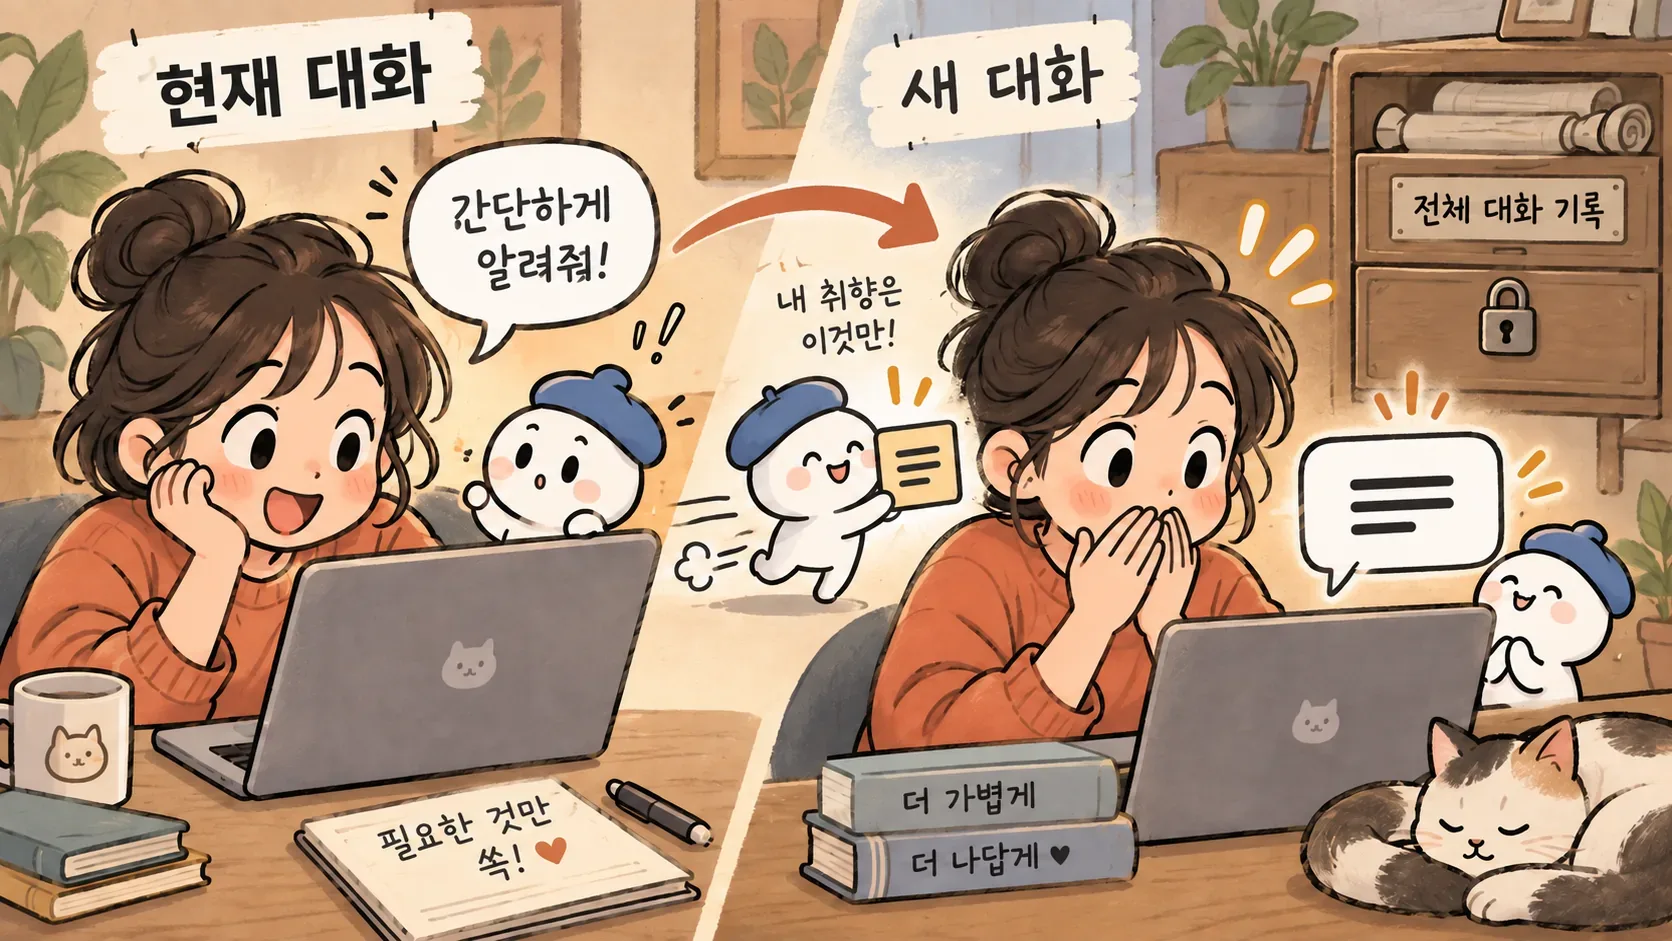
AI 대화가 이어지는 이유와 채팅 저장·개인화 메모리·모델 학습의 차이를 설명합니다. 학습 설정과 대화 삭제를 혼동하지 않고, 민감한 자료를 넣기 전에 계정별 보관·삭제 조건을 확인하는 방법입니다.
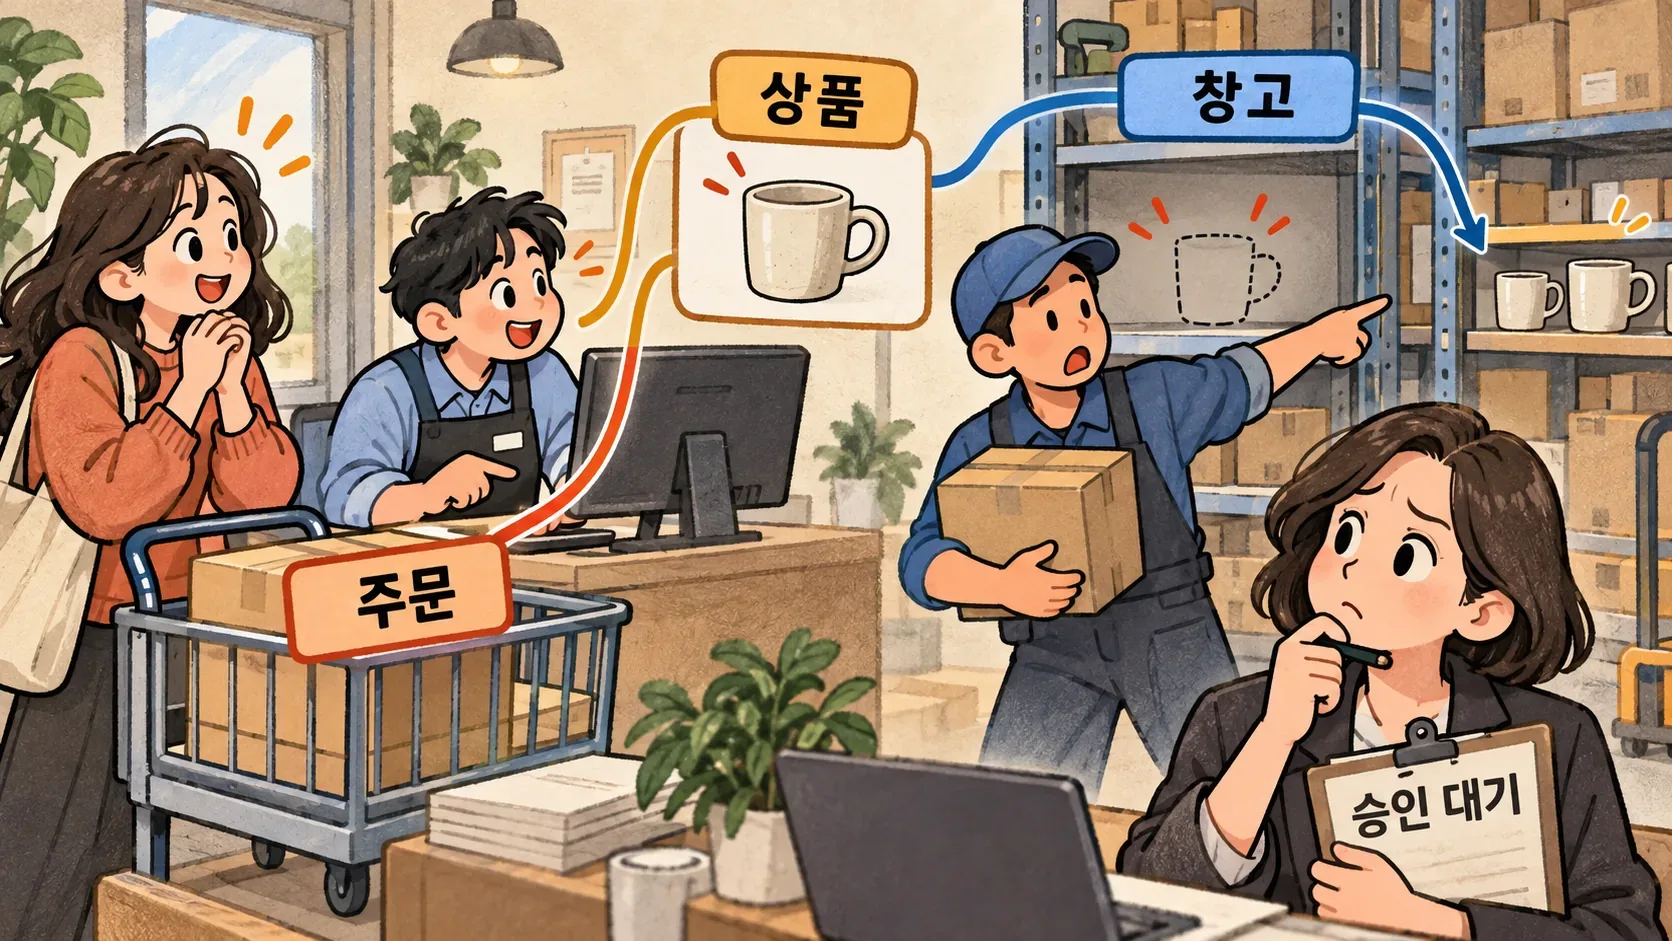
온톨로지의 뜻을 영업·고객지원·회계가 같은 고객을 다르게 부르는 사례로 설명합니다. RAG·위키·지식 그래프와의 차이, Palantir와 FDE의 역할, 기업이 도입할지 판단할 기준을 정리합니다.
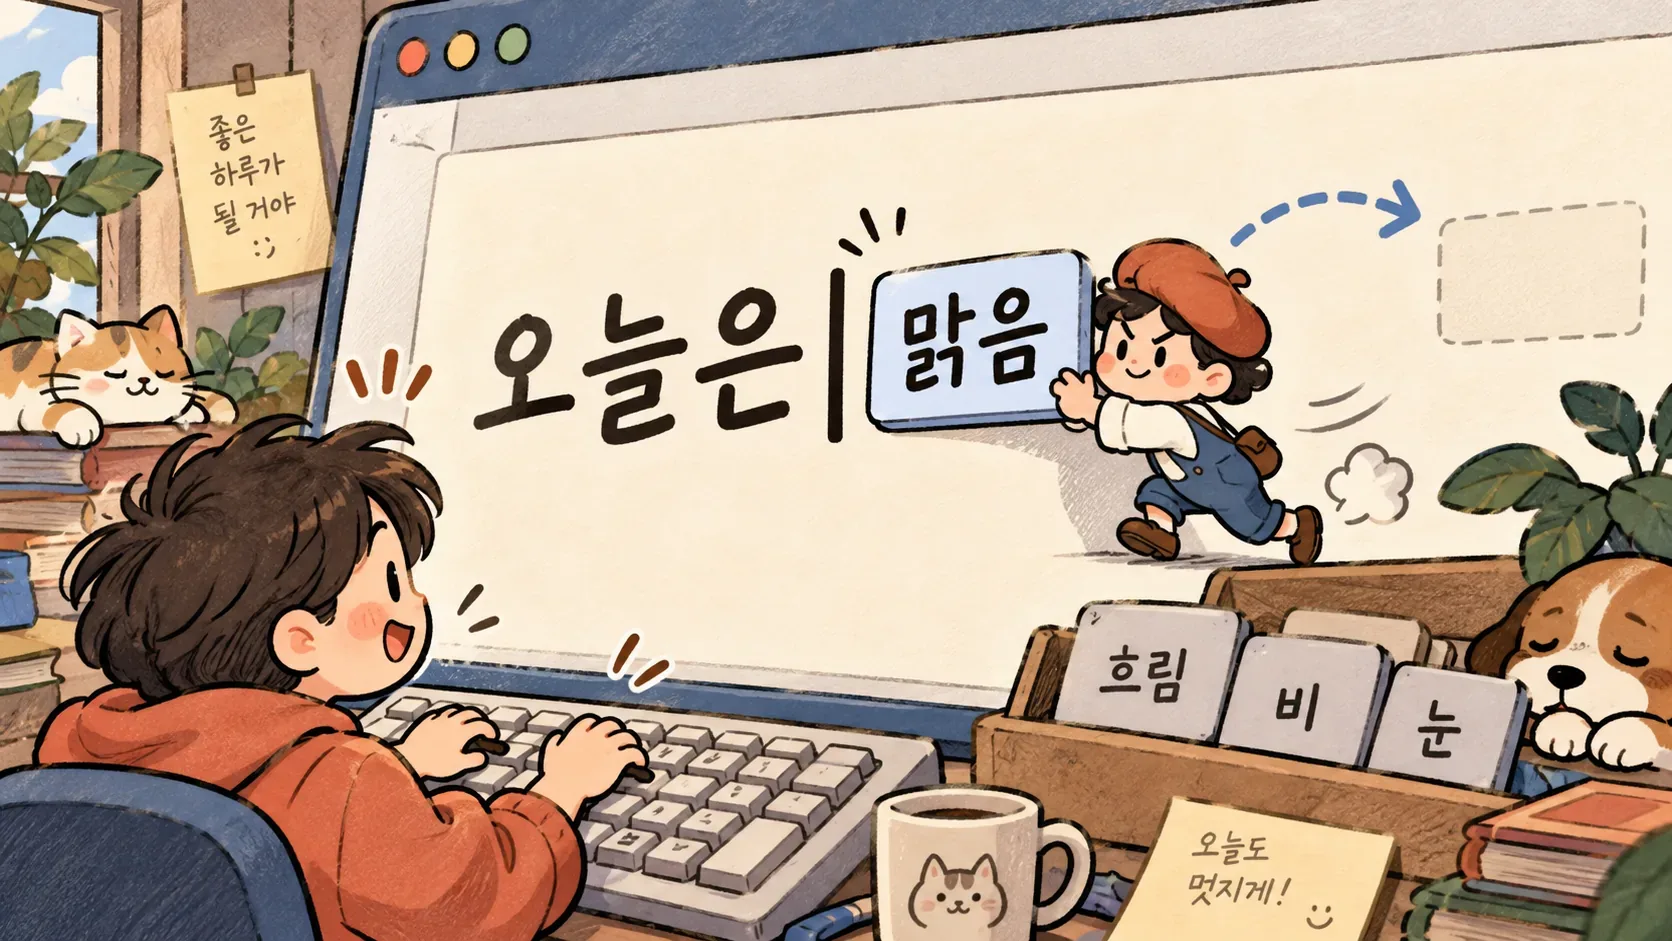
LLM의 뜻과 답변을 만드는 원리를 토큰·문맥·학습 단계로 설명합니다. 잘하는 일과 틀리기 쉬운 일을 구분하고, 챗봇·RAG의 차이와 문서를 직접 제공하는 것으로 충분한 경우를 정리합니다.
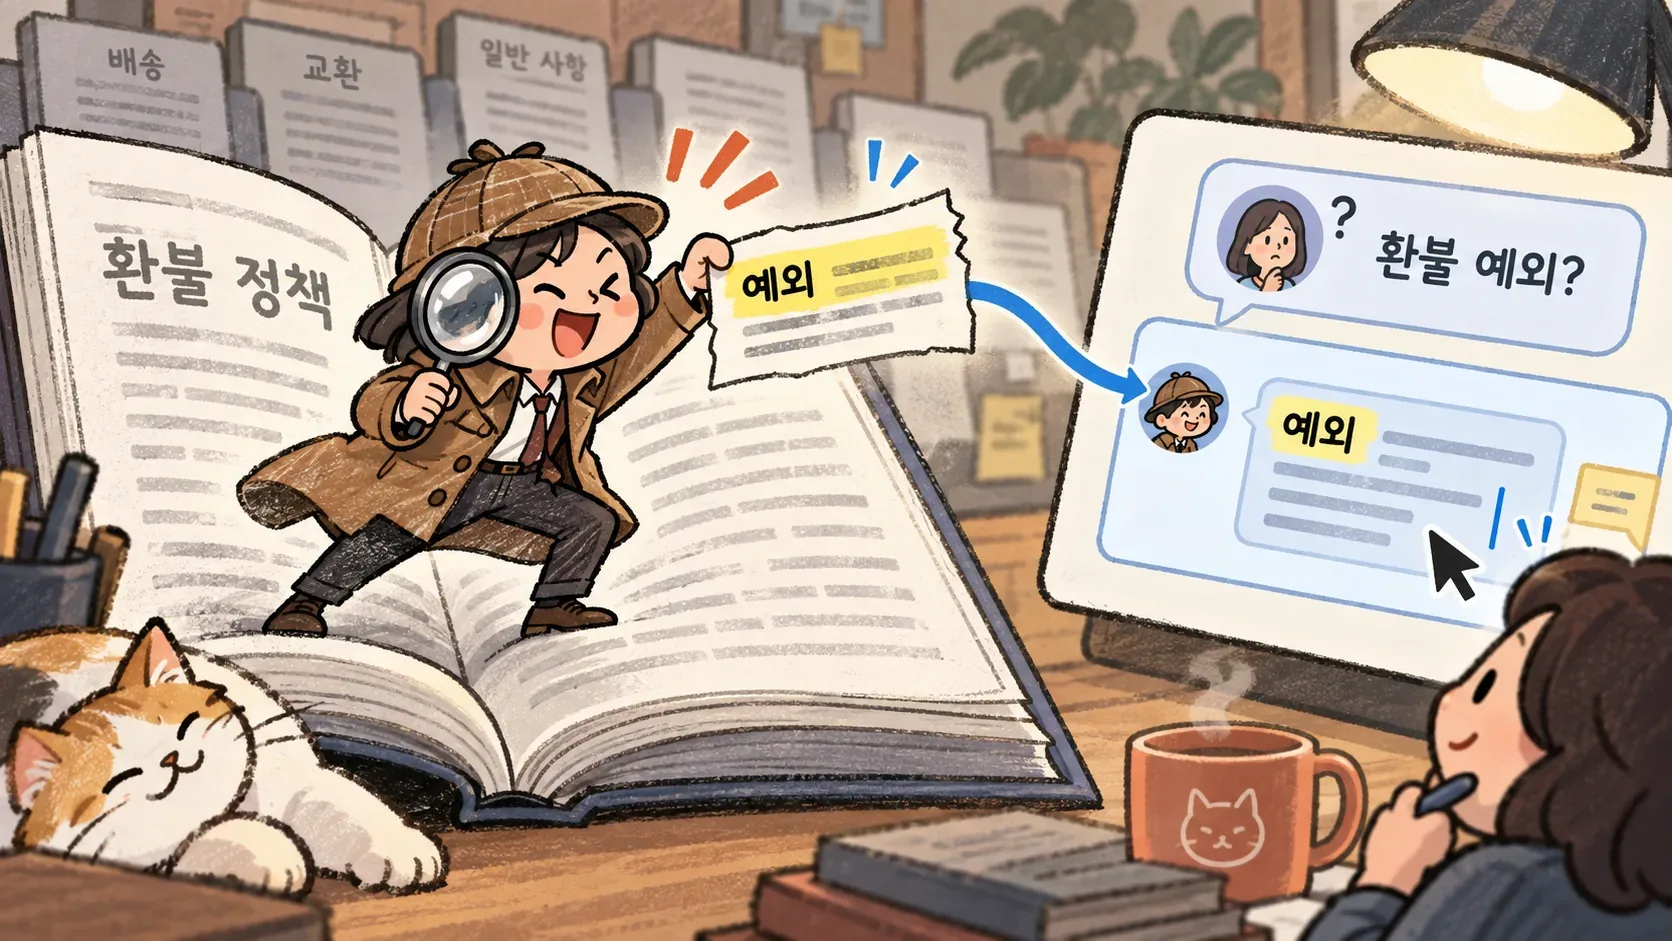
RAG가 외부 문서를 찾아 LLM 답변의 근거로 쓰는 원리를 사내 규정 질문으로 설명합니다. 문서 분할·검색·생성·권한·평가의 구축 순서와 근거를 잘못 찾거나 자료가 없을 때의 실패를 짚습니다.
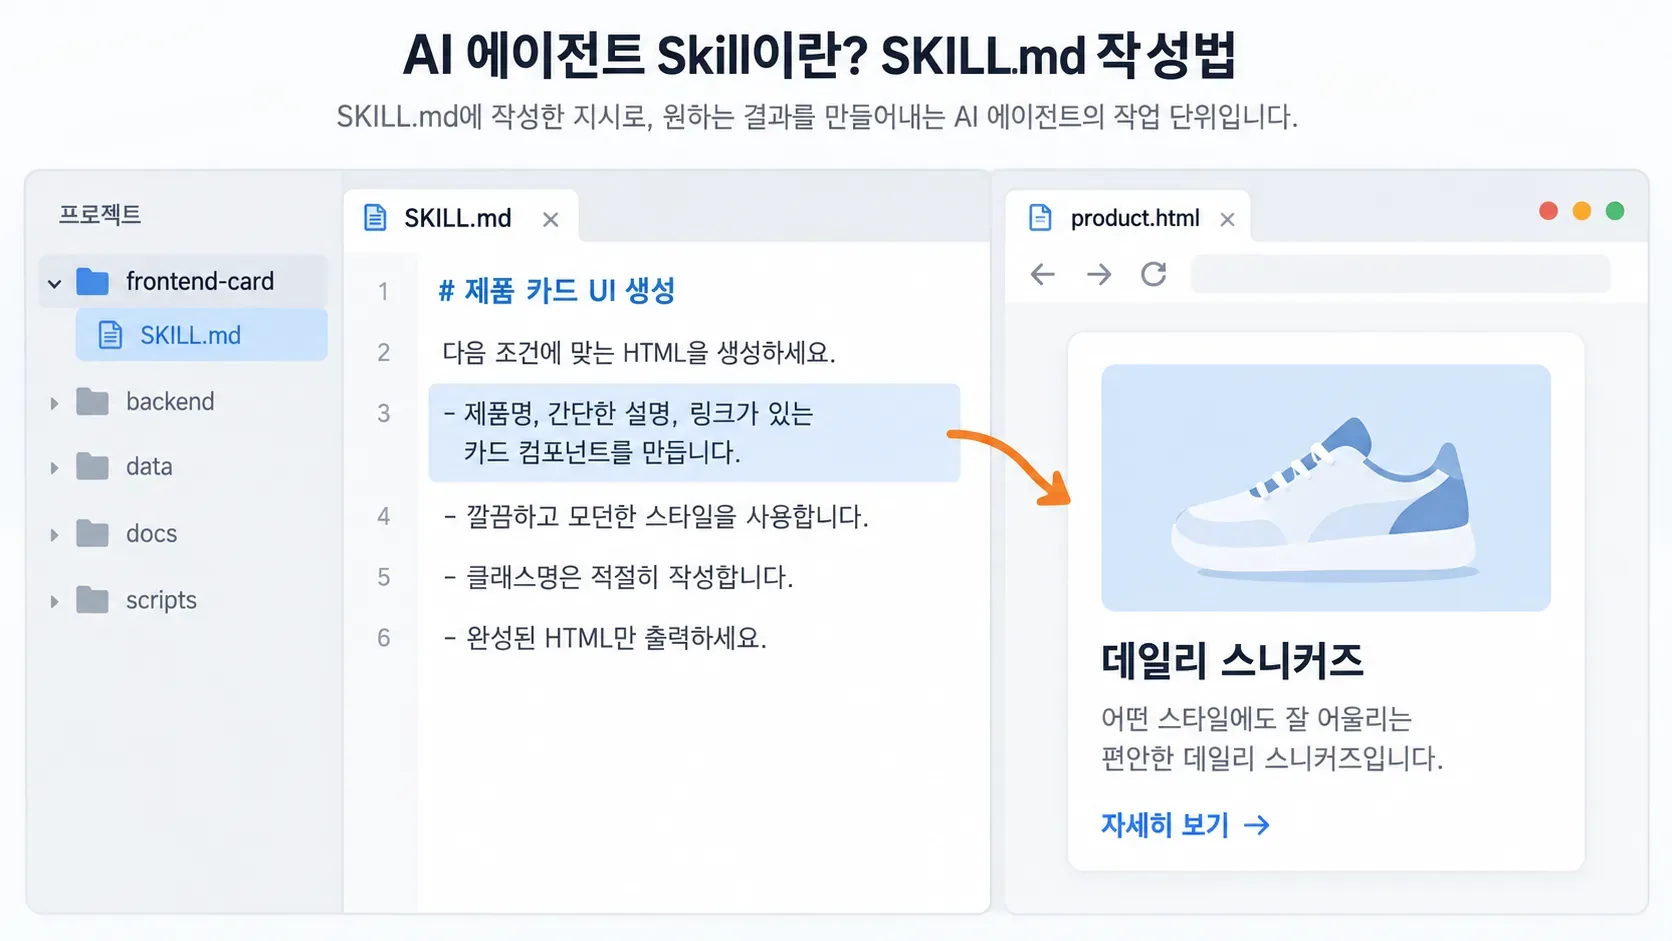
AI 에이전트 Skill의 뜻과 SKILL.md 작성법을 설명합니다. HTML 결과물 예시로 지침·스크립트·참고 자료를 묶고, 같은 작업을 반복할 때 검증할 기준과 설치 전 권한 확인법을 정리합니다.
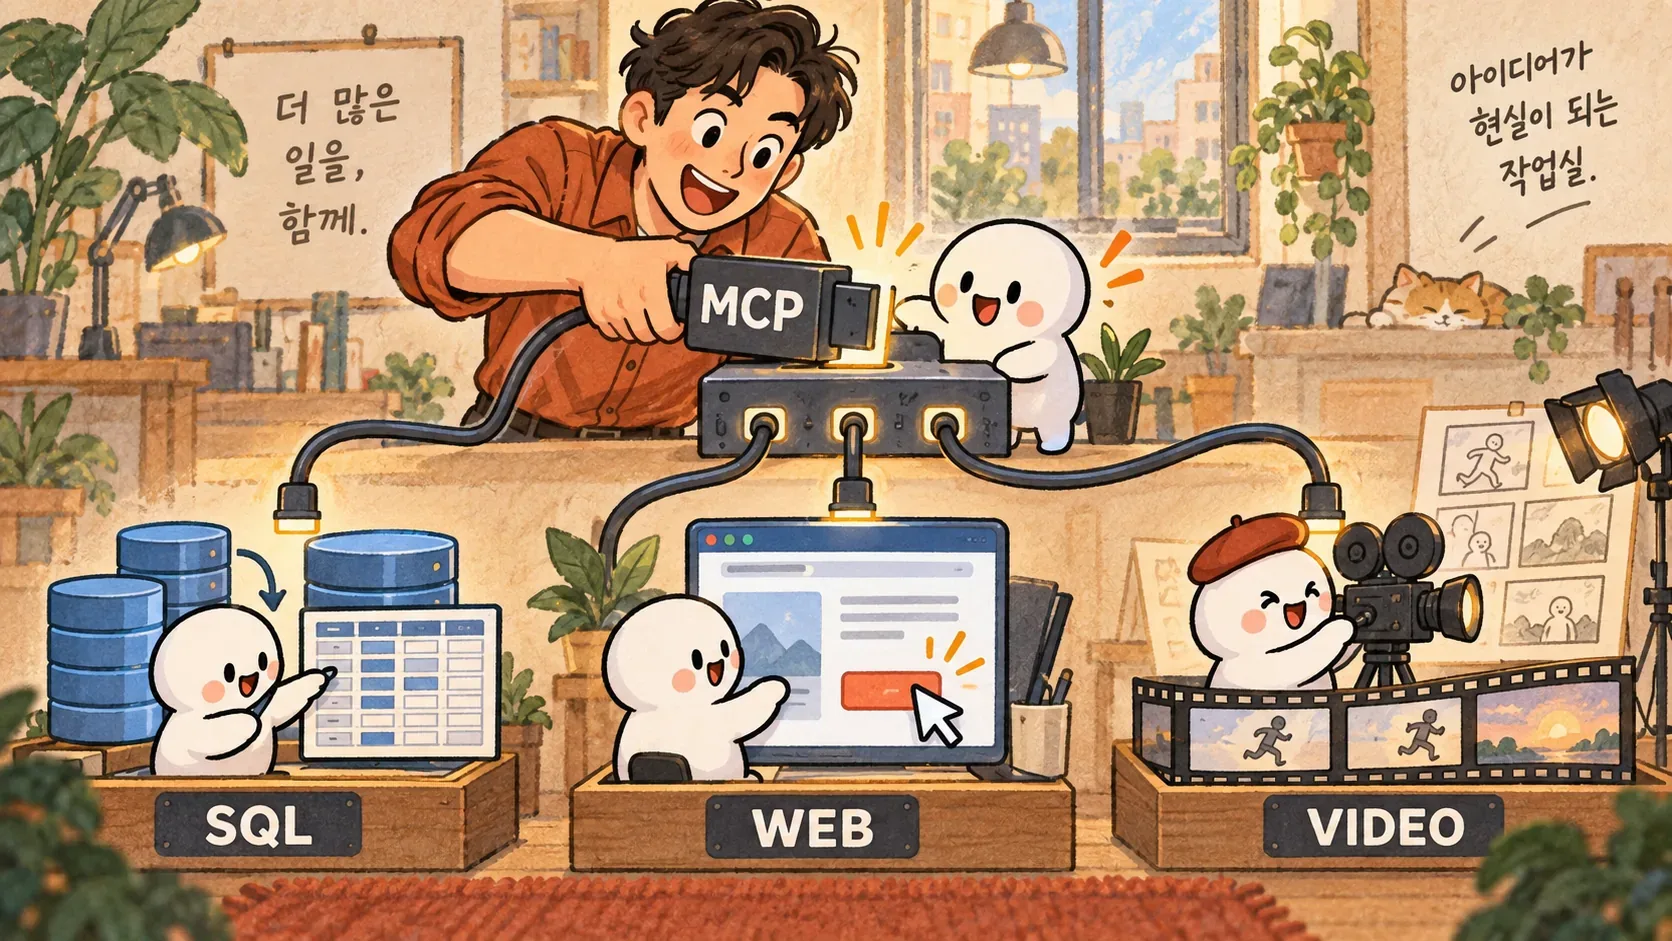
SQL Server 조회·테이블 설계, Playwright 브라우저 검증, Higgsfield 영상 제작으로 MCP 활용법을 설명합니다. 작업별 입력과 확인할 결과, 구현별 기능·권한·검수·비용 차이를 함께 살펴봅니다.
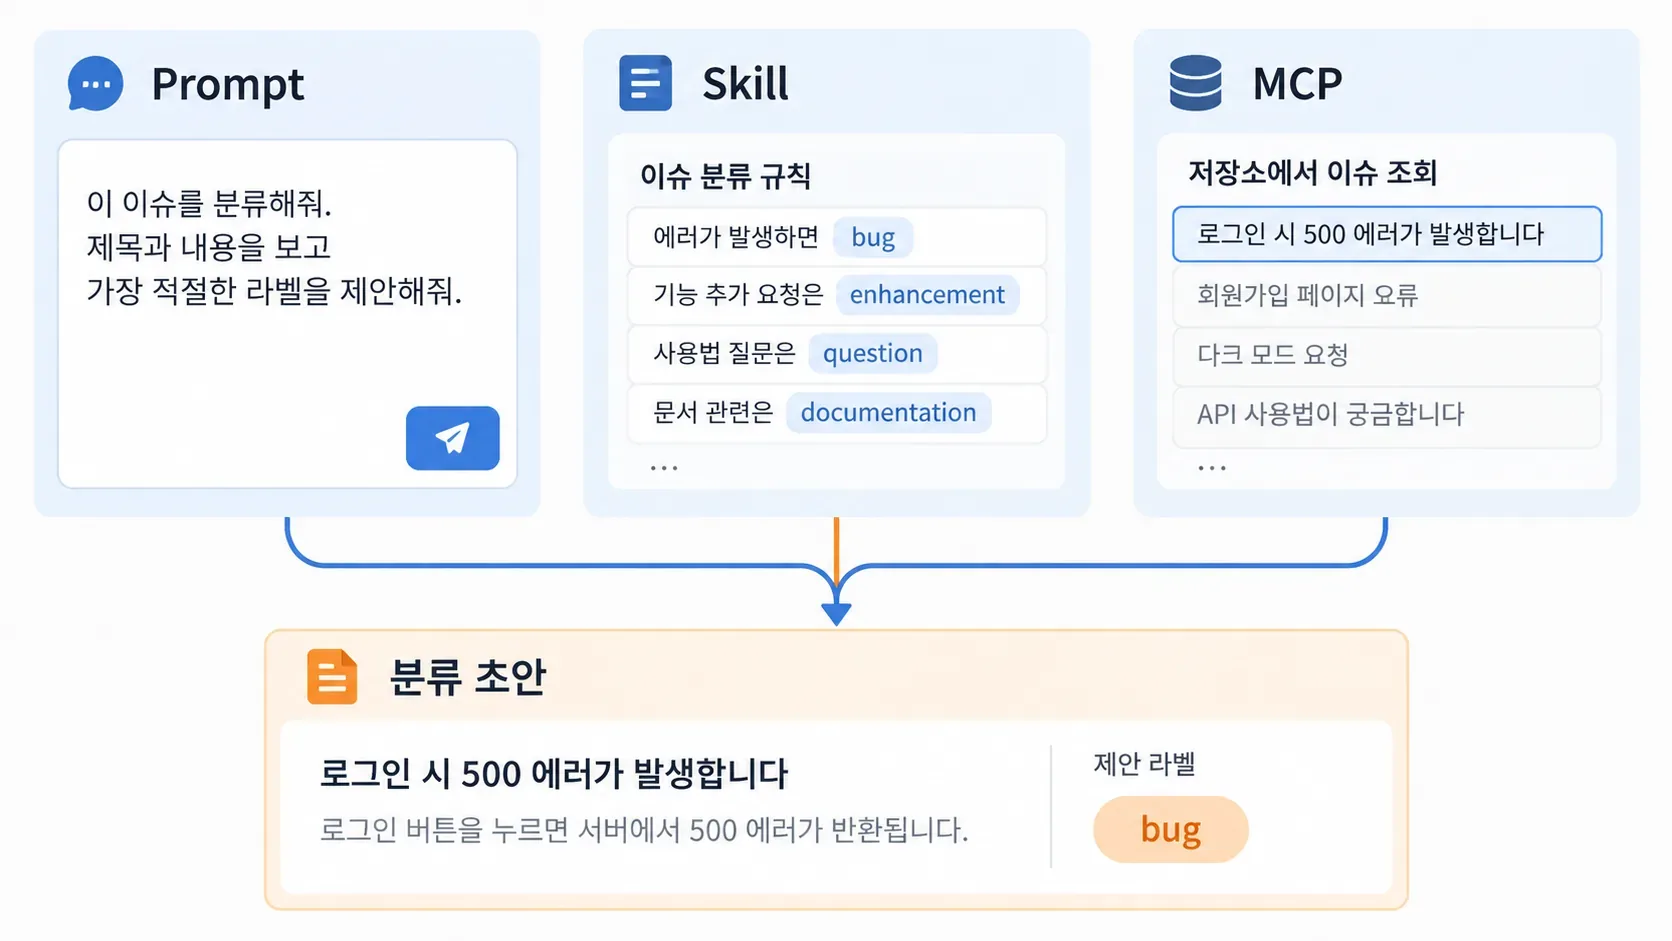
프롬프트는 요청, Skill은 반복 절차, MCP는 도구 연결을 담당합니다. 같은 가상 이슈를 분류하는 예시로 준비·권한·재사용성을 비교하고 CLI·SDK·API로 연결해도 되는 경우를 설명합니다.
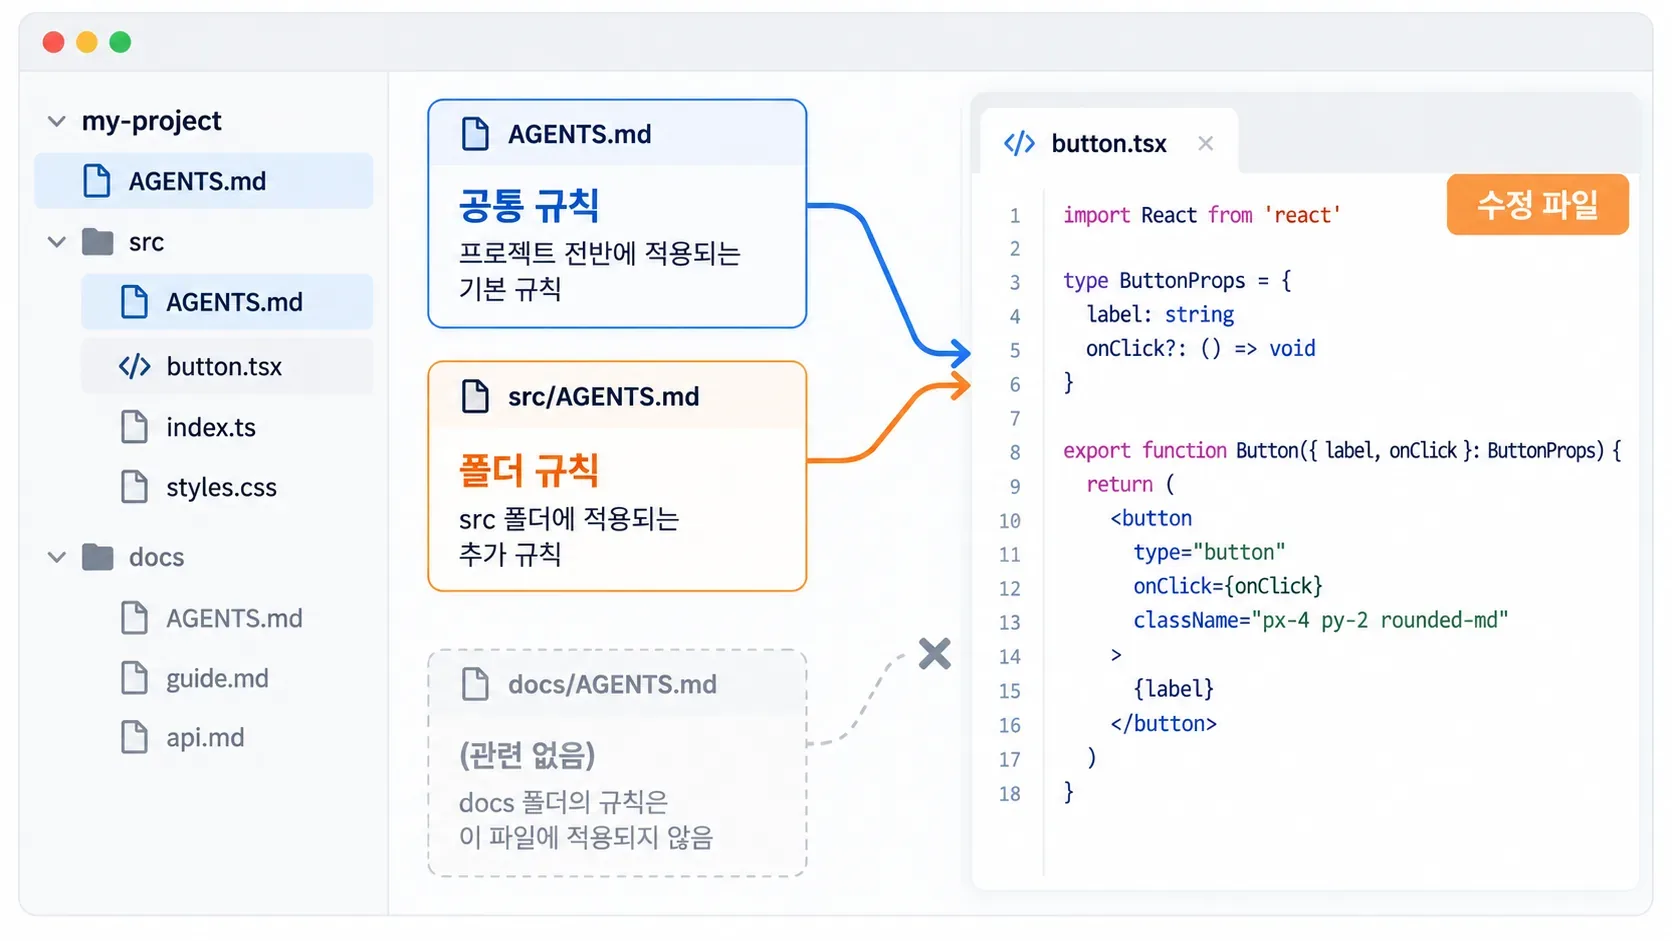
AGENTS.md와 CLAUDE.md에 프로젝트 맥락·수정 범위·검사 명령을 적는 방법입니다. 파일별 적용 범위와 규칙 충돌, 넣지 말아야 할 정보, 테스트·CI로 확인할 완료 조건을 예시로 설명합니다.
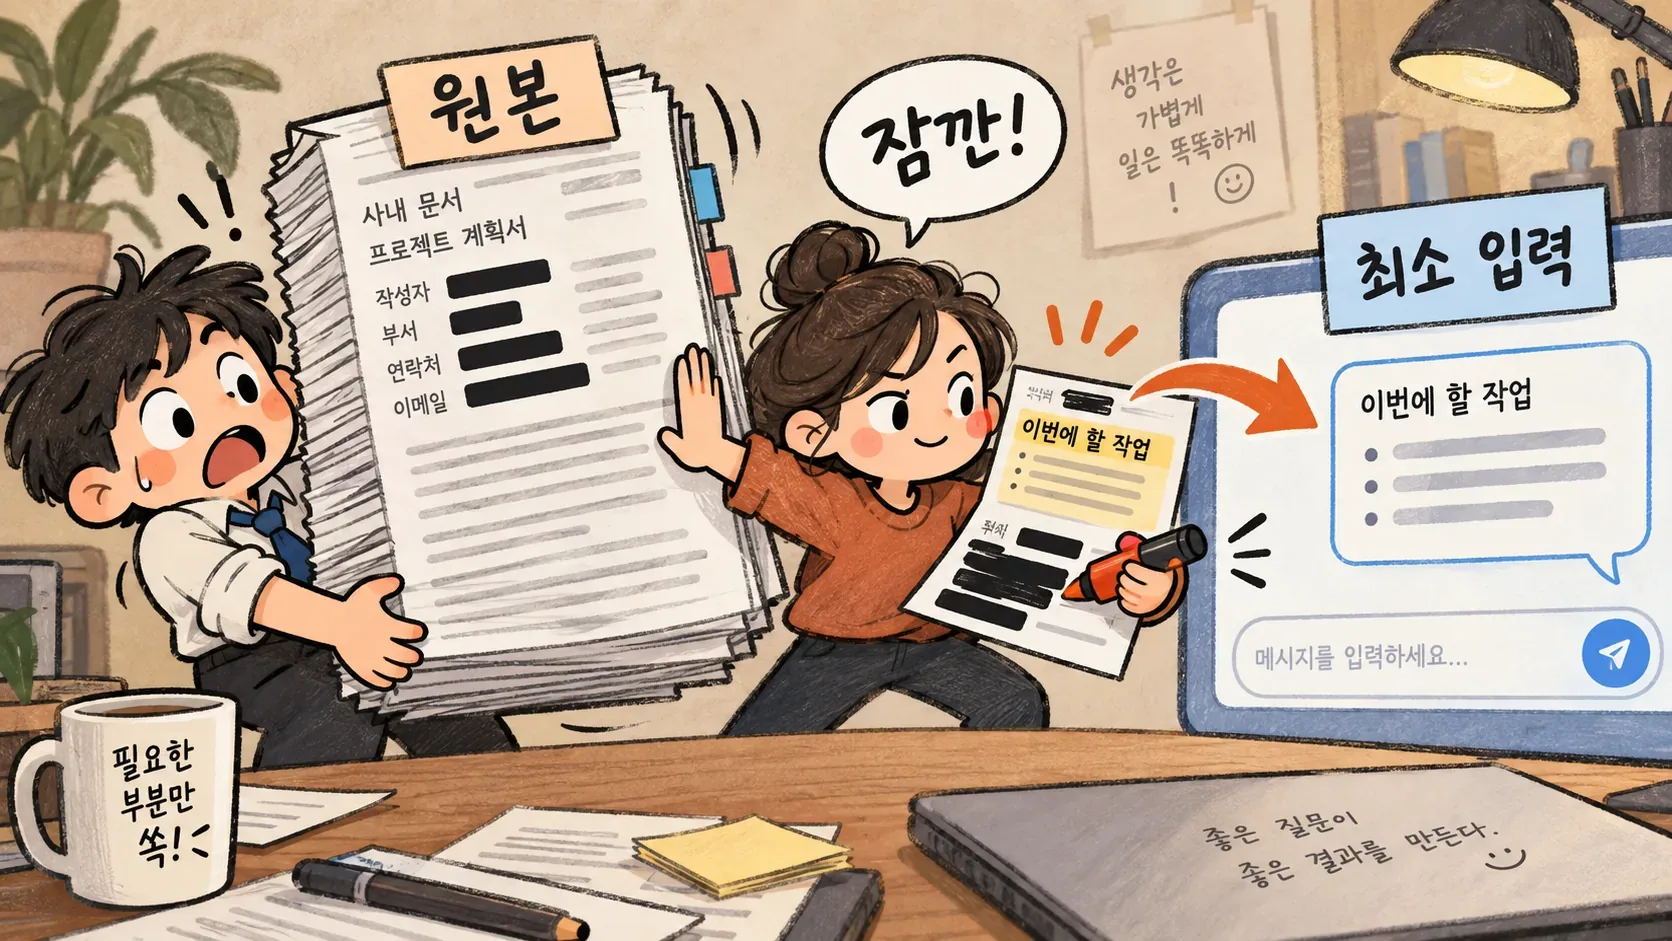
ChatGPT·Claude에 회사 문서나 소스코드를 입력하기 전 확인할 보안 기준입니다. 개인·업무용 계정, 학습과 보관, 외부 연동 권한을 나눠 살피고 민감한 자료를 줄여 전달하는 방법을 설명합니다.
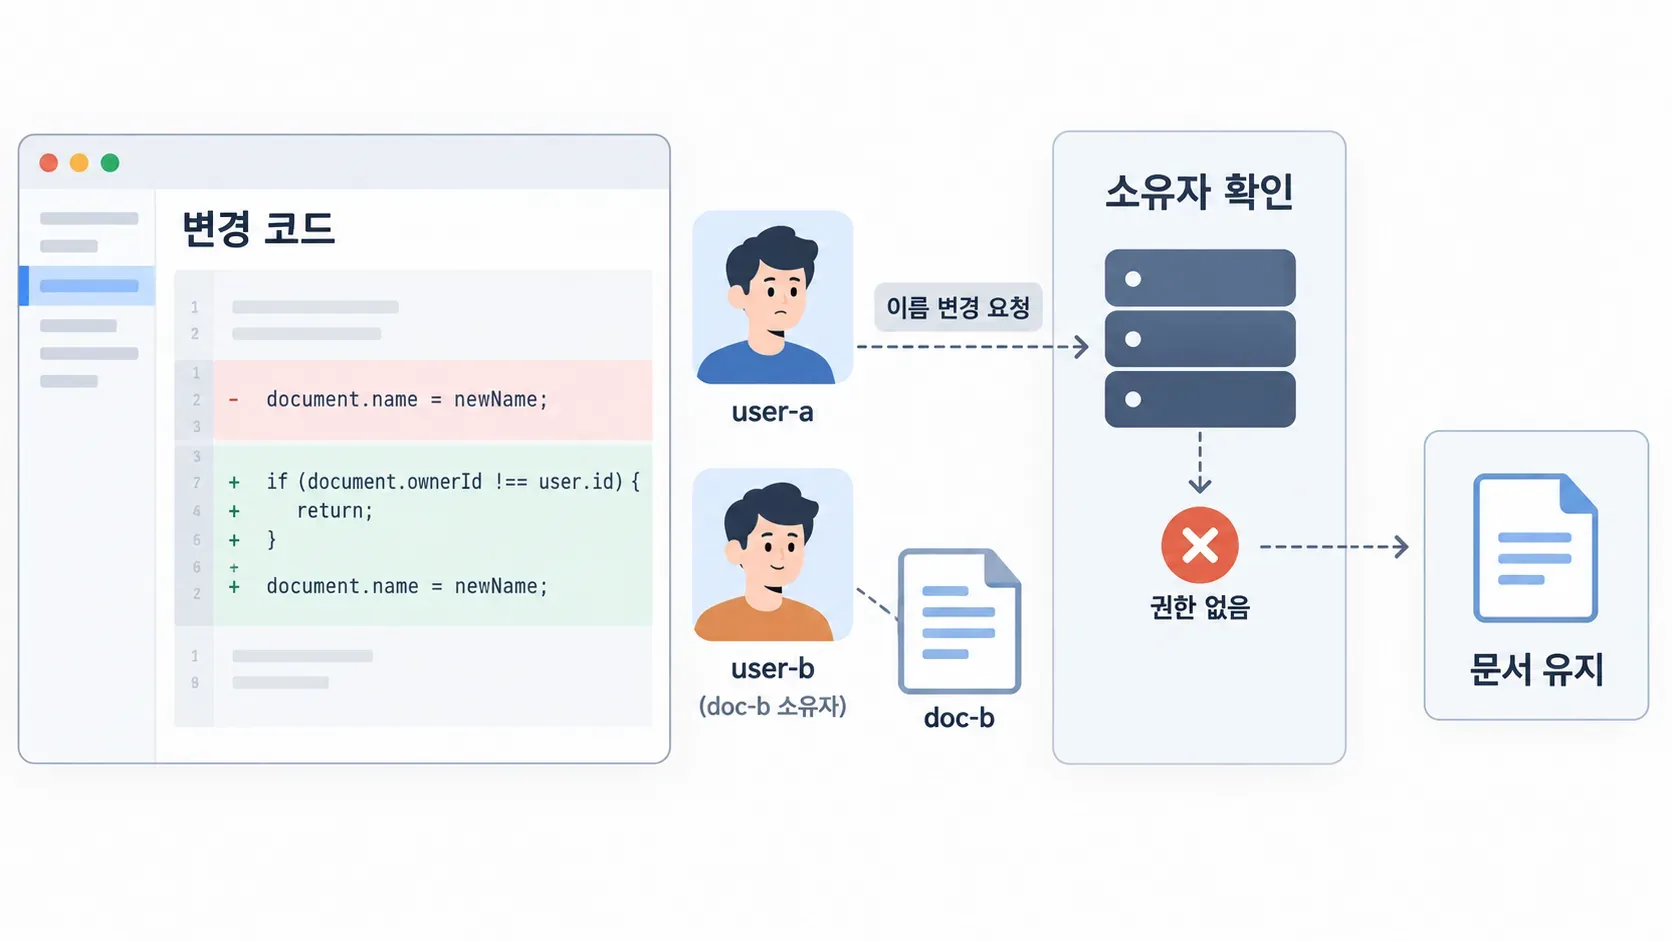
AI가 만든 코드를 배포하기 전 살펴볼 리뷰 체크리스트입니다. 하나의 가상 변경에서 diff, 정상·실패 테스트, 서버 권한과 비밀값, 의존성, 되돌림 절차를 실제 검토 순서로 연결합니다.
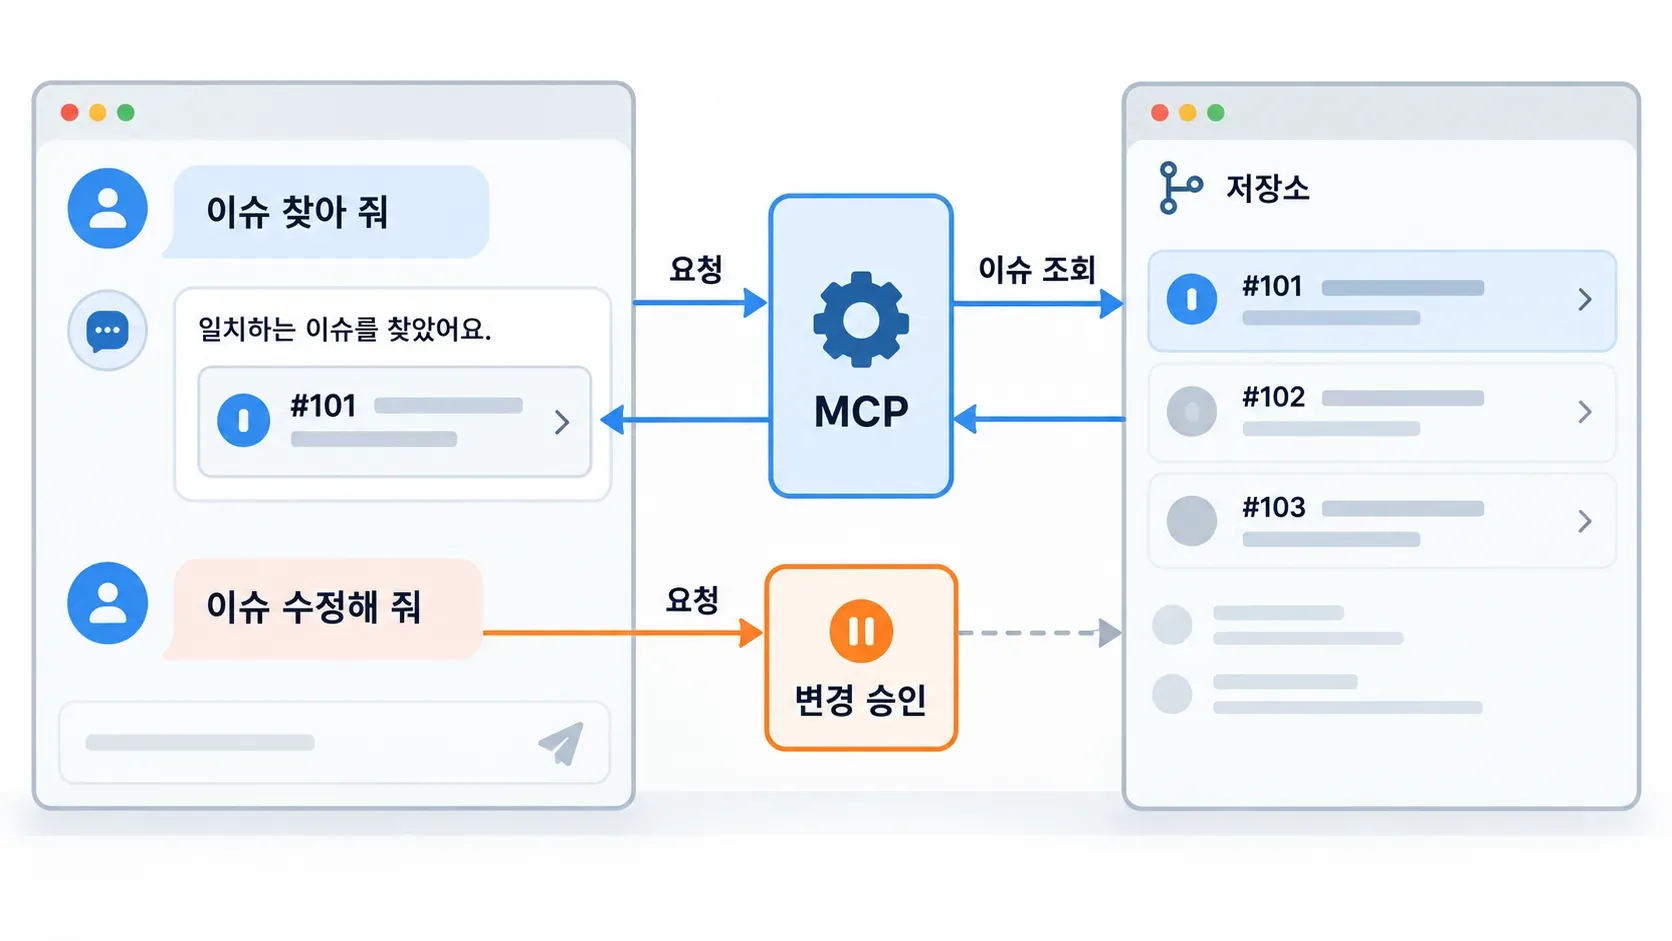
MCP의 뜻과 호스트·클라이언트·서버의 연결 구조를 설명합니다. GitHub·Slack·Google Drive 자료를 다룰 때 읽기·쓰기 권한, 토큰과 프롬프트 인젝션을 구분하고 처음 연결할 범위를 정하는 기준입니다.
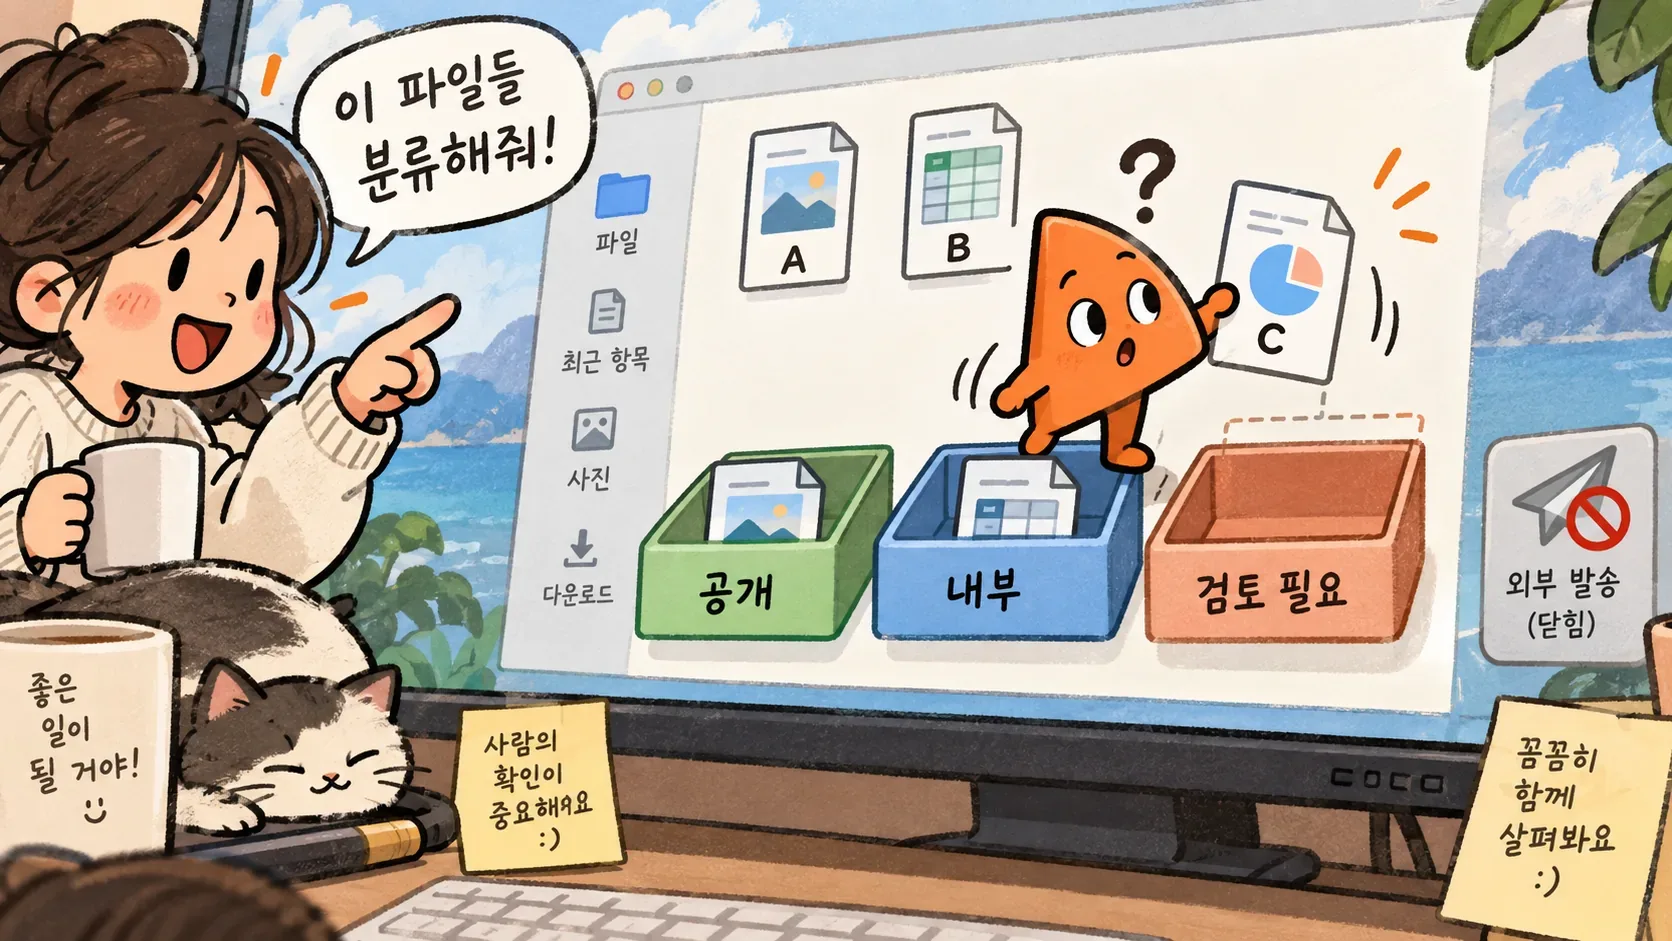
AI 에이전트의 뜻을 챗봇·자동완성·정해진 자동화와 비교합니다. 코딩과 비개발 업무의 목표·도구 사용·결과 확인 예시로, 처음 맡길 일과 사람에게 남길 승인 범위를 정하는 방법입니다.
Codex·Claude Code·Grok의 작업 방식과 비용 구조를 비교합니다. Cursor에서 Grok을 사용하는 경로, 포함 사용량과 추가 결제, 파일·터미널·검수 방식에 맞춰 코딩 도구를 고르는 기준을 정리합니다.
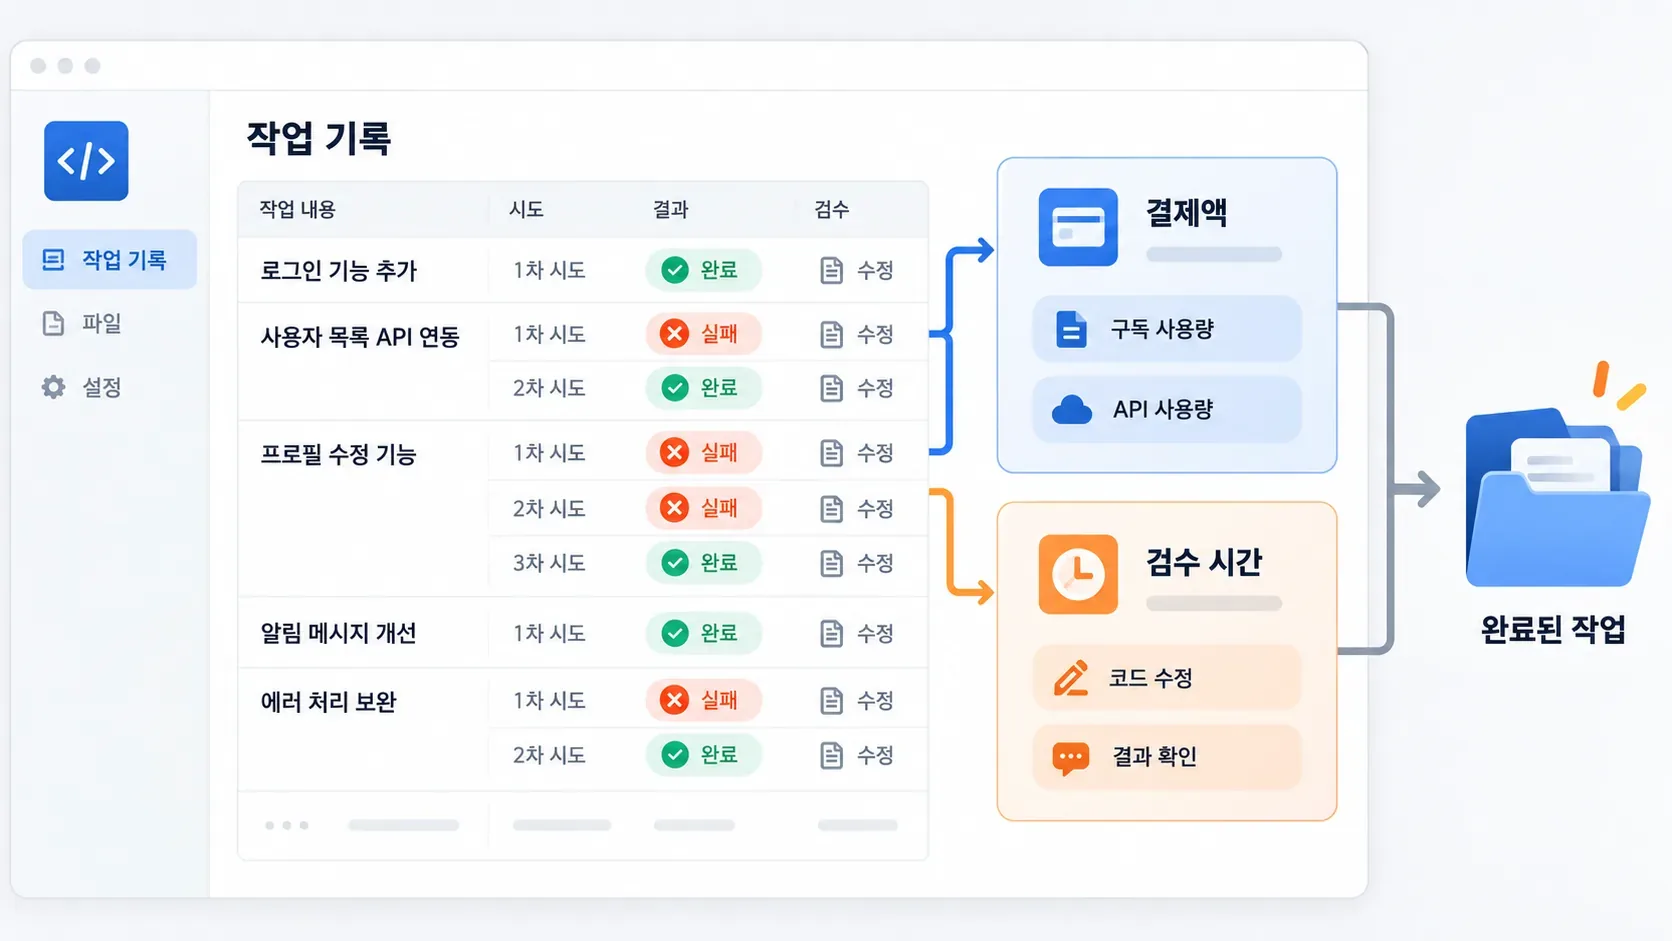
AI 코딩 비용을 구독·API·실행 환경의 실제 결제액과 사람의 작업·재시도·검수 시간으로 나눠 계산합니다. 가상 청구 예시로 성공한 작업 한 건의 비용을 구하고, 다음 달 비교에 필요한 기록을 정리합니다.
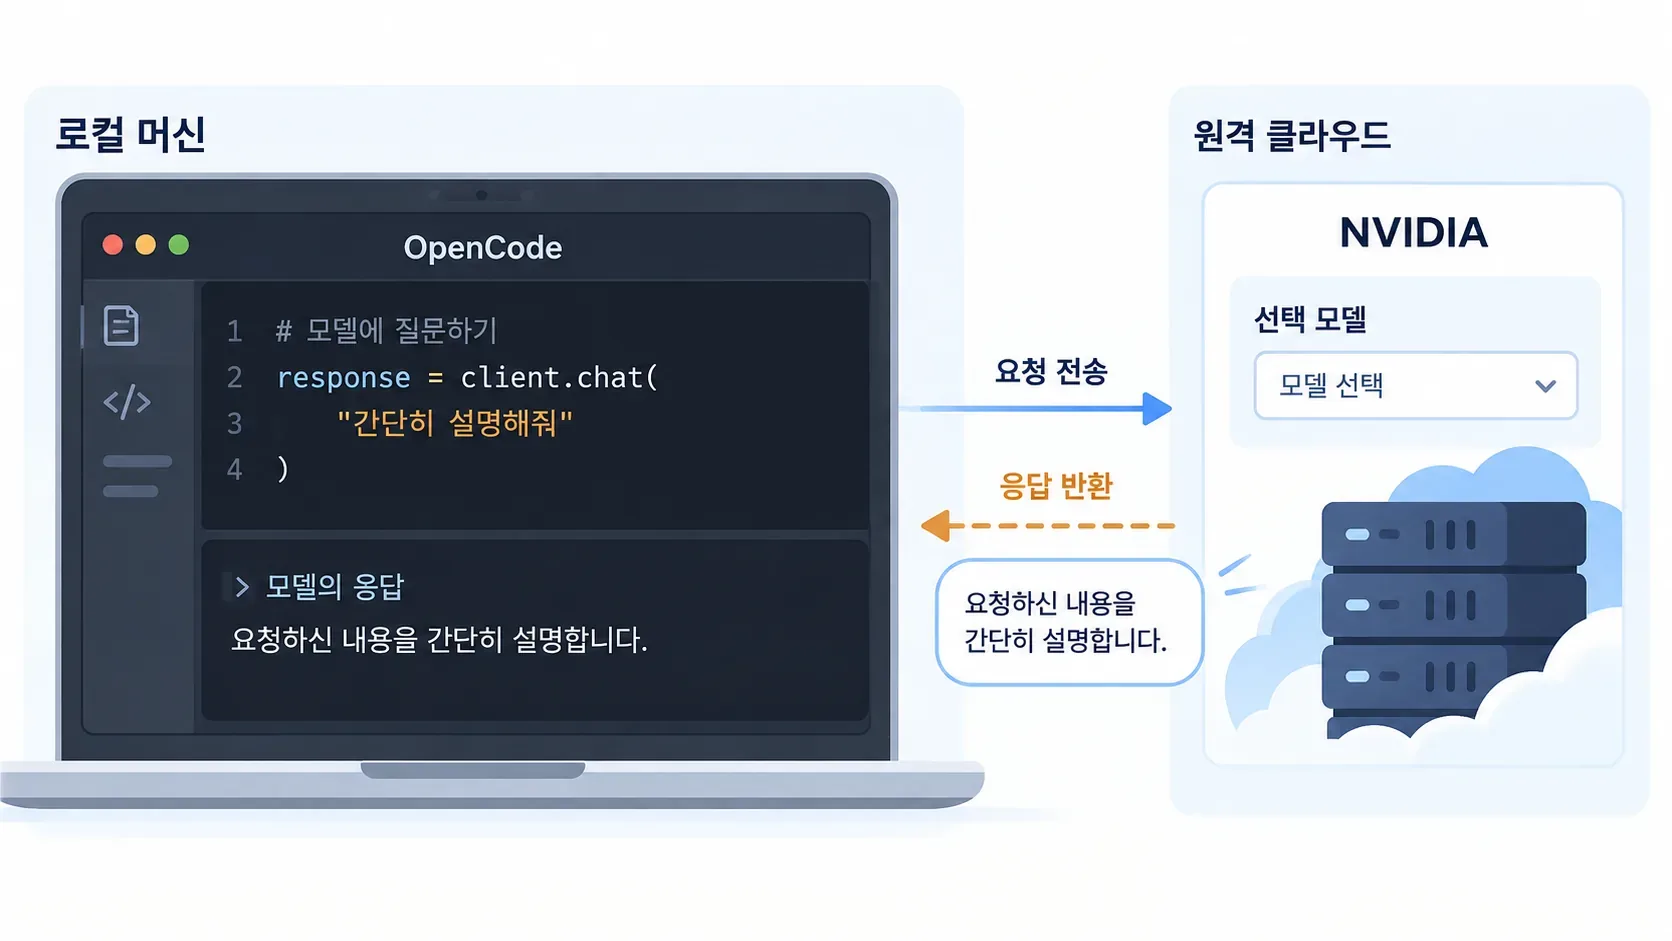
OpenCode에 NVIDIA를 직접 연결하거나 FCC로 Claude Code를 연결하는 설정 방법입니다. Windows·macOS·Linux 설치 명령, Free Endpoint 모델과 local NIM의 차이, 계정별 무료 조건·권한 확인을 정리합니다.